22 listopada 2024
Zanim zbudujesz AI: wykonalność, dane, etyka i prawo
W tym artykule:
Czy to naprawdę problem dla AI?Dane: dostęp ważniejszy niż jakośćNajpierw istniejące modeleKoszty, które trzeba zrozumieć przed startemEtyka, RODO i nowy AI ActCo daje studium wykonalnościWiększość tegorocznych rozmów o AI zaczyna się w tym samym miejscu: firma widziała, co potrafią nowoczesne modele, i chce wiedzieć, czy zrobią to samo dla jej biznesu. Szybkie demo pokazuje, że coś działa na dziesięciu starannie wybranych przykładach. Nie pokazuje, czy zadziała na Twoich danych, w Twojej skali, w Twoim budżecie i zgodnie z prawem.
Dlatego studium wykonalności traktujemy jako pierwszy krok każdego projektu AI. O studiach wykonalności pisaliśmy już w 2021 roku i zasada się nie zmieniła. Zmieniła się lista rzeczy do sprawdzenia. W tym roku wspieraliśmy współfinansowane ze środków publicznych studium wykonalności AI dotyczące analizy ruchu drogowego. Obejmowało wybór algorytmu, ochronę danych i etykę oraz to, czy z wyniku mogą korzystać osoby bez umiejętności programowania; po nim powstał proof of concept. Poniżej – jak wygląda u nas takie studium i czego nauczyło nas to konkretne.
Czy to naprawdę problem dla AI?
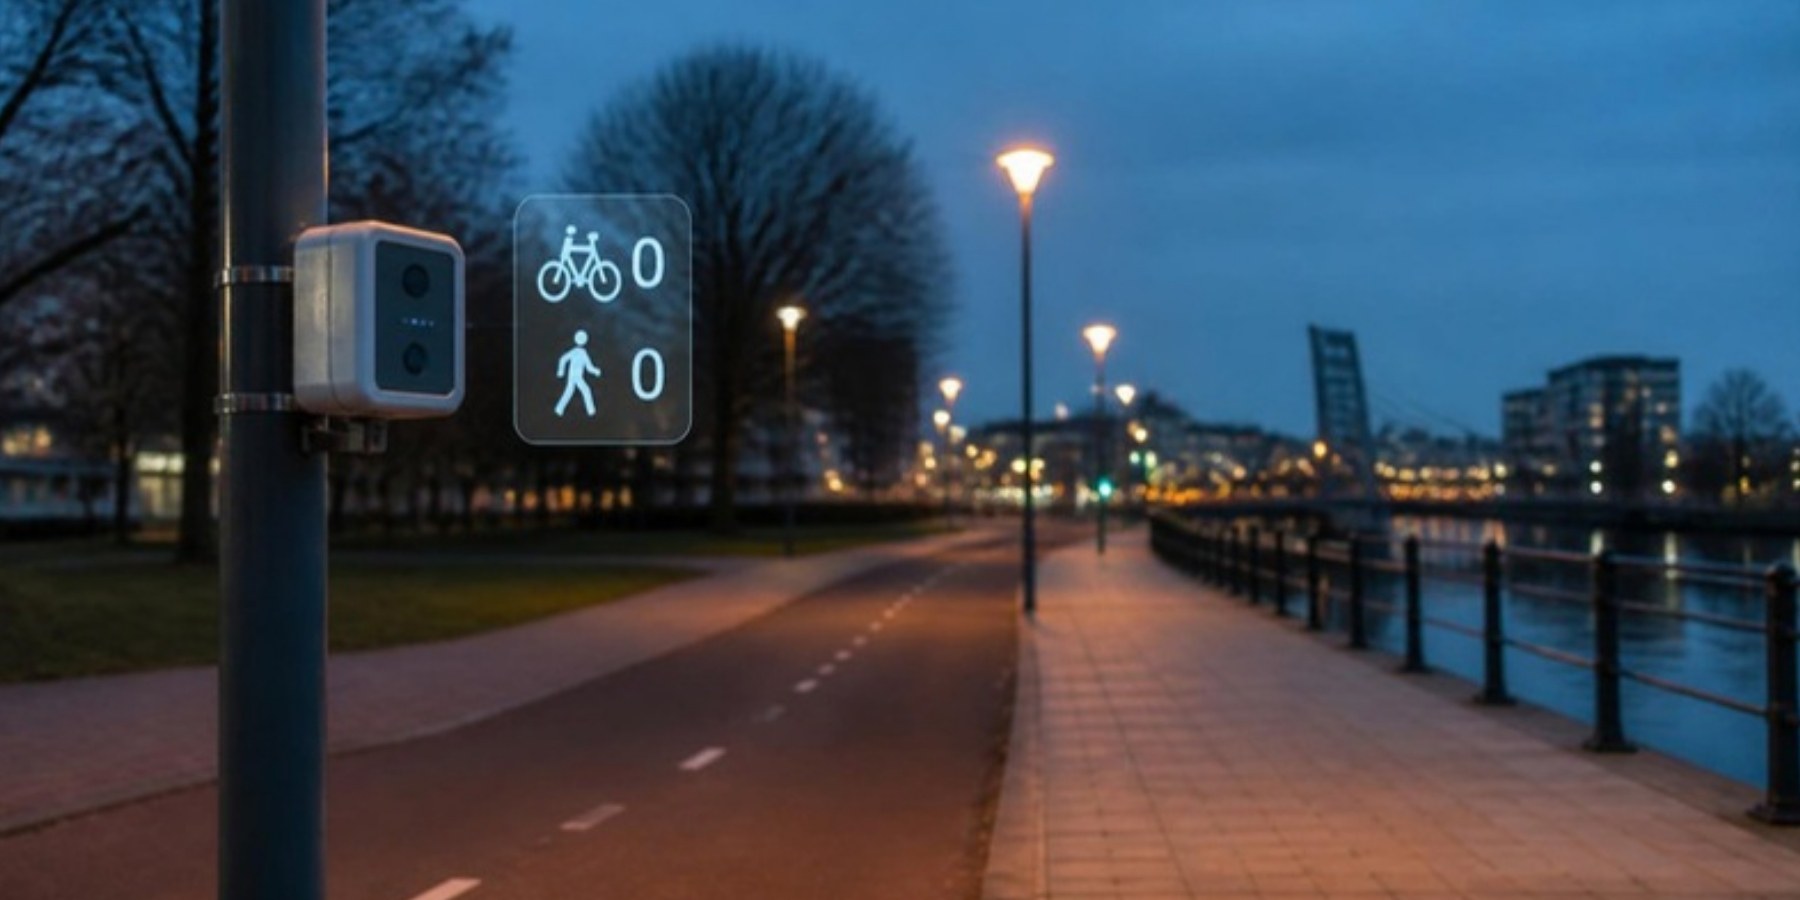
Pierwsze pytanie brzmi: czy problem w ogóle wymaga modelu. Wiele zadań „AI” to w rzeczywistości reguły, integracje albo lepsze raportowanie. AI ma sens tam, gdzie dane wejściowe są nieuporządkowane – na przykład wideo. Nasz przypadek się kwalifikował. Pomysł polegał na tym, żeby istniejące kamery drogowe stały się źródłem statystyk mobilności: liczyć samochody, autobusy, rowery i pieszych bez instalowania nowych czujników. Nawet wtedy zadajemy kilka prostych pytań:
- Jaką decyzję ma wspierać wynik? Tutaj: statystyki dla planistów, a nie sterowanie czymkolwiek w czasie rzeczywistym.
- Jak dobry musi być? Poziom błędów akceptowalny w statystyce może być nie do przyjęcia tam, gdzie wynik uruchamia działanie dotyczące konkretnej osoby.
- Kto będzie go obsługiwać? Niektóre instytucje publiczne mogą budować i utrzymywać takie systemy tylko własnymi siłami albo podlegają surowym zasadom zamówień. To też jest wniosek ze studium wykonalności – i łatwo go sprawdzić na początku.
Dane: dostęp ważniejszy niż jakość
Spodziewaliśmy się, że trudne pytania będą dotyczyć jakości obrazu: nocy, deszczu, niskiej rozdzielczości. Pierwszą przeszkodą okazał się jednak dostęp. Wiele miast nie udostępnia bezpośrednio strumieni ze swoich kamer – z różnych powodów, od kosztów transferu danych po obawy, jak nagrania mogłyby zostać wykorzystane. W Austrii i Niemczech większość publicznych kamer drogowych jest osadzona na stronach internetowych, a nie udostępniana jako strumień. Narzędzie, które „działa z każdą kamerą”, musi więc sobie z tym radzić – albo projekt musi najpierw uzgodnić dostęp do danych.
Drugie pytanie dotyczyło danych treningowych dla klas, które publiczne zbiory pokrywają słabo, takich jak rowery cargo, hulajnogi czy liczba osób w samochodzie. Jedną z odpowiedzi są obrazy syntetyczne, generowane i automatycznie oznaczane narzędziami open source: są tańsze niż ręczne oznaczanie, dodają różnorodności i nie zawierają prawdziwych osób. Mają też realne ograniczenia: wygenerowanym obrazom brakuje niuansów prawdziwych scen, część ma oczywiste błędy, a model trenowany tylko na nich może słabo uogólniać. Rozsądnym zabezpieczeniem jest przejrzenie wygenerowanych danych przez człowieka przed treningiem.
Najpierw istniejące modele
Zaczęliśmy od gotowego detektora wytrenowanego na publicznym zbiorze COCO, który obejmuje już ludzi, rowery, samochody, autobusy i ciężarówki; wszystko poza tymi klasami wymaga treningu – i tu przydają się dane syntetyczne. Zgadzało się to z tym, co widzieliśmy wcześniej w tym roku przy wykrywaniu obiektów na urządzeniach z kamerami na brzegu sieci: wytrenowane detektory i proste filtrowanie dają zaskakująco dużo, a trening ma sens tylko tam, gdzie liczby pokazują lukę. Łatwo przeoczyć dwie rzeczy:
- Licencje. Niektóre popularne detektory mają licencje typu copyleft, które nakładają obowiązki na produkty komercyjne. Sprawdź to, zanim zaczniesz na nich budować.
- Gdzie działa model. Pierwsze demo, które jest za wolne na zwykłym laptopie, to częsty przypadek. Wybór między GPU w chmurze a urządzeniem brzegowym u klienta wpływa na koszt, opóźnienia i prywatność, bo urządzenie brzegowe trzyma obrazy lokalnie. Przy proof of concept najszybszą drogą do wyników jest często instancja w chmurze, którą można uruchamiać i zatrzymywać na żądanie.
Koszty, które trzeba zrozumieć przed startem
Kwoty zależą od przypadku, ale kategorie są zawsze te same: zbieranie i oznaczanie danych, moc obliczeniowa na eksperymenty i trening, inferencja pomnożona przez liczbę kamer, godzin i lat, integracja oraz utrzymanie. Czas GPU rośnie po cichu, więc automatyczne wyłączanie bezczynnych instancji warto wbudować od pierwszego dnia. Najczęściej zapomina się o utrzymaniu: system AI wymaga opieki tak długo, jak działa.
Etyka, RODO i nowy AI Act
Wszystko, co przetwarza obrazy przestrzeni publicznej, przetwarza dane osobowe. Według RODO oznacza to jasną podstawę prawną, minimalizację danych i określone okresy przechowywania, a systematyczne monitorowanie miejsc publicznych zwykle wymaga też oceny skutków dla ochrony danych. Najskuteczniejszy środek jest techniczny: zachowaj tylko liczby potrzebne do analizy, a klatki odrzucaj – najlepiej już na samym urządzeniu.
Od 1 sierpnia 2024 roku obowiązuje unijny AI Act, stosowany etapami. Dzieli systemy AI według ryzyka: praktyki zakazane, wysokie ryzyko (surowe wymagania dotyczące danych, dokumentacji, nadzoru człowieka i dokładności), ograniczone ryzyko (obowiązki przejrzystości) i minimalne ryzyko. Zakazy obowiązują od lutego 2025 roku i obejmują m.in. nieukierunkowane pozyskiwanie wizerunków twarzy do budowy baz rozpoznawania oraz – z wąskimi wyjątkami dla organów ścigania – zdalną identyfikację biometryczną w czasie rzeczywistym w przestrzeni publicznie dostępnej. Liczenie pojazdów i pieszych jest od tego daleko, ale studium wykonalności powinno zaklasyfikować planowany system przed rozpoczęciem prac, bo klasyfikacja wpływa na projekt.
Co daje studium wykonalności
Wynikiem jest decyzja, a nie tylko raport: realizujemy, realizujemy ze zmianami albo zatrzymujemy. Opiera się na wynikach testów na prawdziwych danych, planie danych, kosztach i ryzykach, klasyfikacji prawnej i zakresie kolejnego kroku. Zatrzymanie to pełnoprawny wynik – i dużo tańszy teraz niż po miesiącach prac.
AI potrafi niezwykłe rzeczy, ale tylko wtedy, gdy problem, dane i ramy prawne do siebie pasują. Od sprawdzenia tego dopasowania zaczynamy projekty AI. Jeśli rozważasz taki projekt i chcesz go sprawdzić przed budową, napisz do nas. Jeśli Twoje pytanie dotyczy tego, gdzie AI pasuje do procesów Twojej firmy, a nie do produktu, zacznij od przeglądu procesów.
Zapytaj o wycenę lub poradę

Przeanalizujmy razem koncepcję Twojego projektu i to, na jakim jest etapie.

Otrzymasz od nas wstępną propozycję zakresu projektu oraz szacunek czasu i kosztów.

Konsultacje są objęte umową NDA.