22. November 2024
Bevor Sie KI bauen: Machbarkeit, Daten, Ethik und Recht
In diesem Artikel:
Ist das wirklich ein Problem für KI?Daten: Zugang kommt vor QualitätZuerst vorhandene ModelleKosten, die man vor dem Start verstehen sollteEthik, DSGVO und der neue AI ActWas am Ende einer Machbarkeitsstudie stehtDie meisten Gespräche über KI, die wir in diesem Jahr geführt haben, beginnen an derselben Stelle: Ein Unternehmen hat gesehen, was moderne Modelle können, und möchte wissen, ob sie dasselbe für sein Geschäft leisten. Eine schnelle Demo zeigt, dass etwas bei zehn handverlesenen Beispielen funktioniert. Sie zeigt nicht, ob es mit Ihren Daten, in Ihrem Umfang, mit Ihrem Budget und im Rahmen des Rechts funktioniert.
Deshalb ist eine Machbarkeitsstudie für uns der erste Schritt jedes KI-Projekts. Wir haben schon 2021 über Machbarkeitsstudien geschrieben, und am Prinzip hat sich nichts geändert. Geändert hat sich die Liste dessen, was zu prüfen ist. In diesem Jahr haben wir eine öffentlich kofinanzierte KI-Machbarkeitsstudie zur Analyse des Straßenverkehrs unterstützt. Sie umfasste die Wahl des Algorithmus, Datenschutz und Ethik sowie die Frage, ob Menschen ohne Programmierkenntnisse das Ergebnis nutzen können; danach folgte ein Proof of Concept. Im Folgenden lesen Sie, wie eine solche Studie bei uns aussieht und was uns diese gelehrt hat.
Ist das wirklich ein Problem für KI?
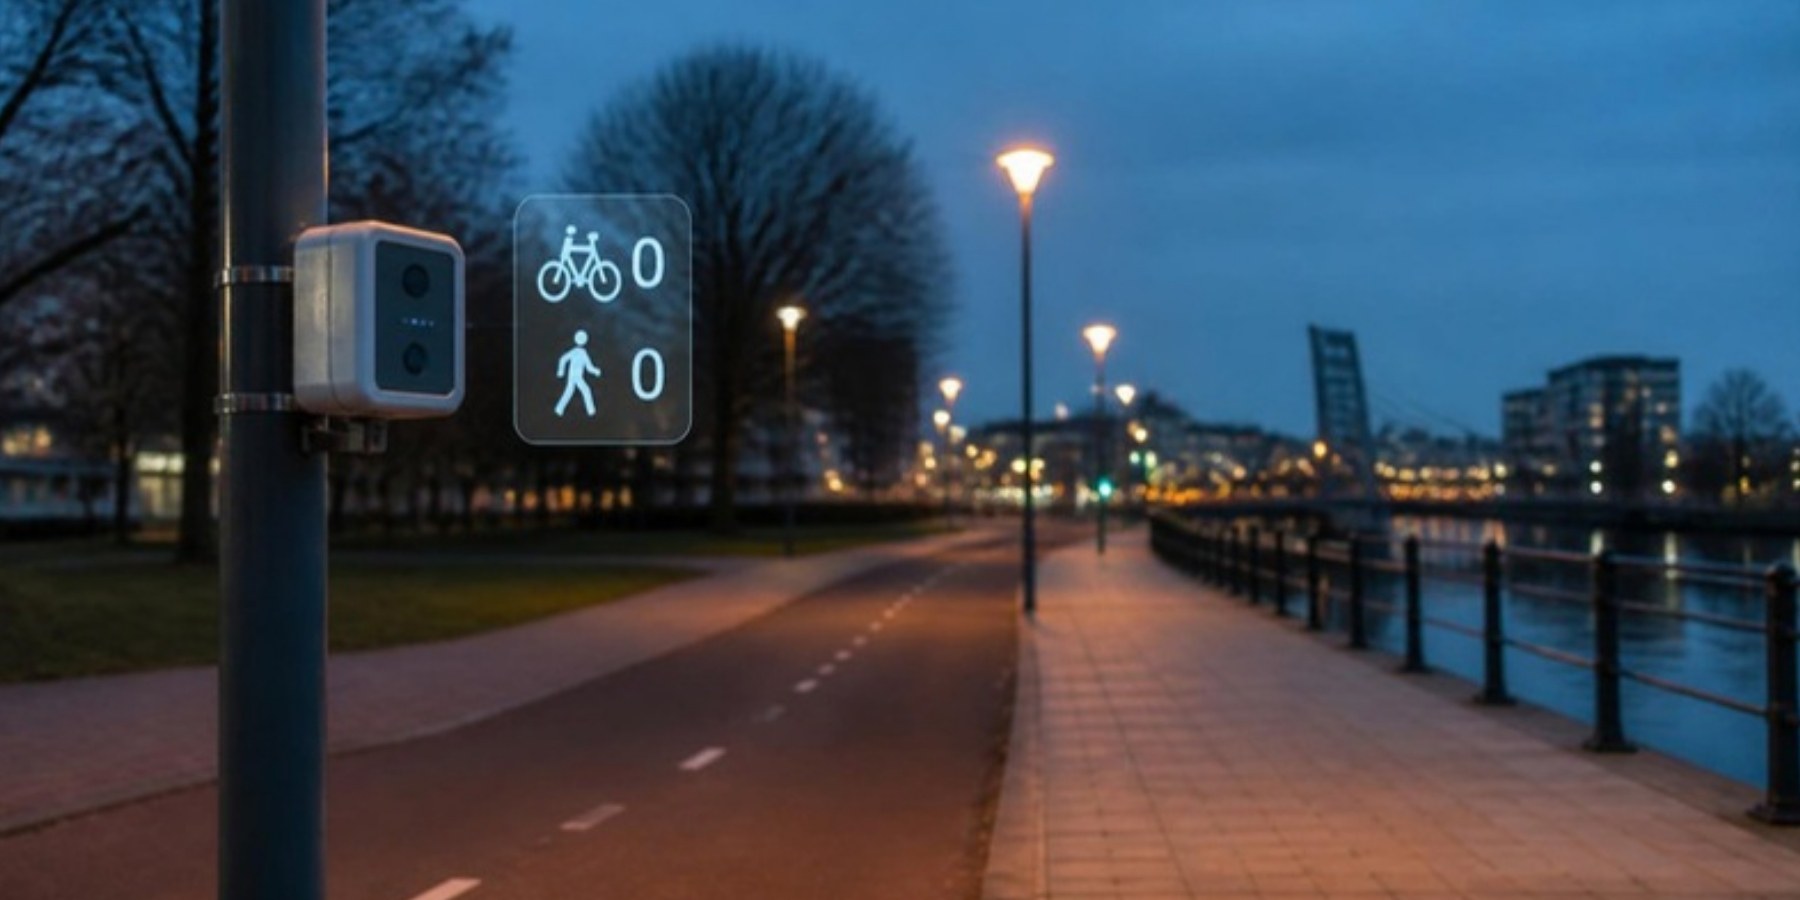
Die erste Frage lautet, ob das Problem überhaupt ein Modell braucht. Viele „KI“-Aufgaben drehen sich eigentlich um Regeln, Integrationen oder besseres Reporting. KI lohnt sich dort, wo die Eingangsdaten unstrukturiert sind, etwa bei Video. Unser Fall erfüllte das. Die Idee war, vorhandene Verkehrs-Webcams zu einer Quelle für Mobilitätsstatistiken zu machen und Autos, Busse, Fahrräder und Fußgänger zu zählen, ohne neue Sensoren zu installieren. Auch dann stellen wir ein paar einfache Fragen:
- Welche Entscheidung soll das Ergebnis unterstützen? Hier: Statistiken für die Verkehrsplanung, keine Echtzeitsteuerung von irgendetwas.
- Wie gut muss es sein? Eine Fehlerquote, die für Statistiken in Ordnung ist, kann inakzeptabel sein, sobald das Ergebnis eine Maßnahme auslöst, die einen echten Menschen betrifft.
- Wer wird es betreiben? Manche öffentlichen Einrichtungen dürfen solche Systeme nur mit eigenem Personal aufbauen und betreiben oder unterliegen strengen Vergaberegeln. Auch das ist ein Ergebnis der Machbarkeitsprüfung, und es lässt sich früh klären.
Daten: Zugang kommt vor Qualität
Wir hatten erwartet, dass die schwierigen Fragen die Bildqualität betreffen: Nacht, Regen, geringe Auflösung. Das erste Hindernis war jedoch der Zugang. Viele Städte gewähren keinen direkten Zugriff auf ihre Kamerastreams, aus Gründen von Datenübertragungskosten bis zu Bedenken, wie das Material weiterverwendet werden könnte. In Österreich und Deutschland sind die meisten öffentlichen Verkehrs-Webcams in Webseiten eingebettet, statt als Stream angeboten zu werden. Ein Werkzeug, das „mit jeder Kamera funktioniert“, muss damit umgehen können, oder das Projekt muss zuerst den Datenzugang vereinbaren.
Die zweite Frage betraf Trainingsdaten für Klassen, die öffentliche Datensätze schlecht abdecken, etwa Lastenräder, Scooter oder die Zahl der Personen in einem Auto. Eine Antwort sind synthetische Bilder, die mit Open-Source-Werkzeugen erzeugt und automatisch annotiert werden: Sie sind günstiger als manuelles Annotieren, bringen Vielfalt und zeigen keine echten Menschen. Sie haben aber echte Grenzen: Erzeugten Bildern fehlen die Feinheiten realer Szenen, manche enthalten offensichtliche Fehler, und ein nur damit trainiertes Modell generalisiert womöglich schlecht. Eine menschliche Prüfung der erzeugten Daten vor dem Training ist eine sinnvolle Absicherung.
Zuerst vorhandene Modelle
Wir begannen mit einem fertigen Detektor, der auf dem öffentlichen COCO-Datensatz vortrainiert ist und bereits Personen, Fahrräder, Autos, Busse und Lkw abdeckt; alles darüber hinaus erfordert Training, und hier kommen synthetische Daten ins Spiel. Das deckte sich mit dem, was wir zuvor in diesem Jahr bei der Objekterkennung auf Kamerageräten am Edge gesehen hatten: Vortrainierte Detektoren plus einfache Filterung bringen einen überraschend weit, und Training lohnt sich nur dort, wo die Zahlen eine Lücke zeigen. Zwei Punkte werden leicht übersehen:
- Lizenzen. Manche beliebten Detektoren stehen unter Copyleft-Lizenzen, die kommerziellen Produkten Pflichten auferlegen. Prüfen Sie das, bevor Sie darauf aufbauen.
- Wo das Modell läuft. Eine erste Demo, die auf einem normalen Laptop zu langsam ist, kommt häufig vor. Die Wahl zwischen einer Cloud-GPU und einem Edge-Gerät beim Kunden beeinflusst Kosten, Latenz und Datenschutz, denn ein Edge-Gerät behält die Bilder lokal. Für einen Proof of Concept ist eine Cloud-Instanz, die sich bei Bedarf starten und stoppen lässt, oft der schnellste Weg zu Ergebnissen.
Kosten, die man vor dem Start verstehen sollte
Die Beträge hängen vom Fall ab, die Kategorien sind aber immer dieselben: Datenerhebung und Annotation, Rechenleistung für Experimente und Training, Inferenz multipliziert mit Kameras, Stunden und Jahren, Integration und Wartung. GPU-Zeit wächst unbemerkt, deshalb lohnt es sich, das automatische Abschalten ungenutzter Instanzen vom ersten Tag an einzubauen. Am häufigsten wird die Wartung vergessen: Ein KI-System braucht Betreuung, solange es läuft.
Ethik, DSGVO und der neue AI Act
Alles, was Bilder des öffentlichen Raums verarbeitet, verarbeitet personenbezogene Daten. Nach der DSGVO bedeutet das eine klare Rechtsgrundlage, Datenminimierung und festgelegte Speicherfristen, und eine systematische Überwachung öffentlicher Bereiche erfordert in der Regel auch eine Datenschutz-Folgenabschätzung. Die wirksamste Maßnahme ist technisch: nur die Zählwerte behalten, die die Analyse braucht, und die Einzelbilder verwerfen, am besten schon auf dem Gerät.
Seit dem 1. August 2024 ist der EU AI Act in Kraft und gilt stufenweise. Er ordnet KI-Systeme nach Risiko: verbotene Praktiken, hohes Risiko (strenge Anforderungen an Daten, Dokumentation, menschliche Aufsicht und Genauigkeit), begrenztes Risiko (Transparenzpflichten) und minimales Risiko. Die Verbote gelten ab Februar 2025 und umfassen unter anderem das ungezielte Auslesen von Gesichtsbildern zum Aufbau von Gesichtserkennungsdatenbanken und, mit engen Ausnahmen für die Strafverfolgung, biometrische Echtzeit-Fernidentifizierung in öffentlich zugänglichen Räumen. Das Zählen von Fahrzeugen und Fußgängern ist davon weit entfernt, aber eine Machbarkeitsstudie sollte das geplante System vor Entwicklungsbeginn einstufen, denn die Einstufung prägt das Design.
Was am Ende einer Machbarkeitsstudie steht
Das Ergebnis ist eine Entscheidung, nicht nur ein Bericht: weitermachen, mit Änderungen weitermachen oder stoppen. Sie stützt sich auf Testergebnisse mit echten Daten, einen Datenplan, Kosten und Risiken, die rechtliche Einstufung und einen Umfang für den nächsten Schritt. Stoppen ist ein gültiges Ergebnis, und jetzt weit günstiger als nach Monaten der Entwicklung.
KI kann Bemerkenswertes leisten, aber nur, wenn Problem, Daten und rechtlicher Rahmen zusammenpassen. Mit der Prüfung dieser Passung beginnen wir KI-Projekte. Wenn Sie ein solches Projekt erwägen und es vor dem Bau prüfen möchten, sprechen Sie uns an. Wenn Ihre Frage eher lautet, wo KI in die Prozesse Ihres Unternehmens passt als in ein Produkt, beginnen Sie mit einer Prozessanalyse.
Angebot oder Beratung anfragen

Wir sehen uns Ihr Projektkonzept und seinen aktuellen Stand gemeinsam an.

Sie erhalten von uns einen ersten Vorschlag zum Projektumfang sowie eine Zeit- und Kostenschätzung.

Die Beratung ist durch eine Geheimhaltungsvereinbarung (NDA) geschützt.