
19 października 2026
Obraz i dane z czujników w czasie rzeczywistym
W tym artykule:
Co naprawdę znaczy „czas rzeczywisty”Wyniki zamiast pikseliMałe procesory, prawdziwe modeleFizyka też ma głosŹródła, które zawodzą inaczejTeren wygrywa z benchmarkiemOd studium wykonalności do wdrożeniaNajważniejsze wnioskiPrzy 30 klatkach na sekundę urządzenie ma 33 milisekundy, żeby zarejestrować obraz, przesłać go, przetworzyć i na niego zareagować – a potem wszystko zaczyna się od nowa. Opisujemy, co sprawia, że przetwarzanie obrazu i danych z czujników w czasie rzeczywistym jest trudne, i czego nauczyliśmy się, budując kamery, czujniki i urządzenia z edge AI.
Co naprawdę znaczy „czas rzeczywisty”
„Czas rzeczywisty” często rozumie się jako „szybko”. W przetwarzaniu obrazu oznacza coś bardziej wymagającego: na czas, za każdym razem. Kamera pracująca z prędkością 30 klatek na sekundę dostarcza nowy obraz co 33,3 milisekundy (1000 podzielone przez liczbę klatek na sekundę). Przy 60 klatkach na sekundę to okno kurczy się do 16,7 milisekundy. Wszystko, co dzieje się z klatką, musi się w nim zmieścić – inaczej następna klatka przyjdzie, zanim system skończy z poprzednią.
To okno jest wspólne dla wszystkich etapów. Matrycę trzeba naświetlić i odczytać, obraz przenieść do pamięci i przygotować dla modelu, model musi go przeanalizować, a wynik zamienić w decyzję albo komunikat. Żaden z tych etapów nie dostaje własnych 33 milisekund. Jeśli przygotowanie obrazu potrwa dłużej, niż zakładał plan, na inferencję zostanie mniej czasu.
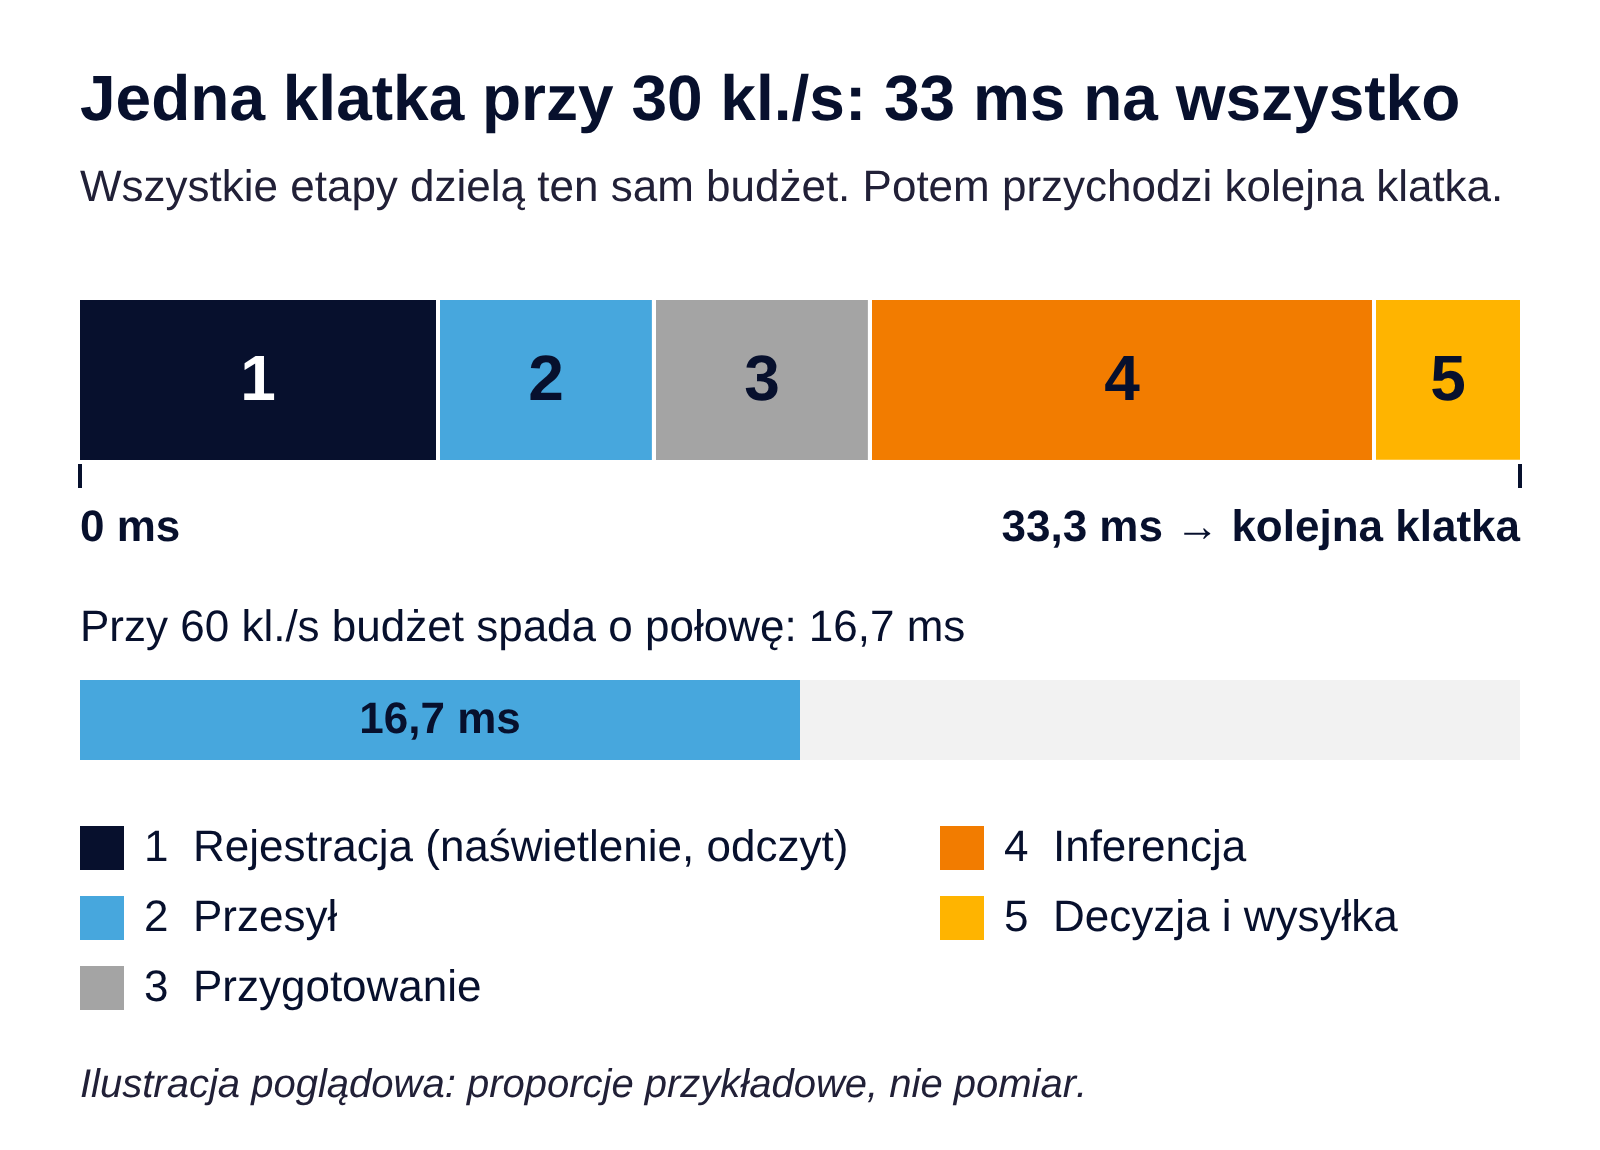
Budżet jednej klatki: 33 ms przy 30 klatkach na sekundę (schemat ilustracyjny)
Dlatego średnia prędkość niewiele mówi. System, który większość klatek obsługuje z zapasem, ale od czasu do czasu potrzebuje na jedną klatkę dwa razy więcej czasu, nie jest systemem 30 klatek na sekundę. Gubi klatki albo tworzy kolejkę, a każda kolejna klatka czeka w niej dłużej niż poprzednia. Gdy wynikiem jest statystyka odświeżana co kwadrans, spóźniona klatka nikomu nie szkodzi. Gdy system ma reagować na to, co widzi kamera, spóźnienie decyduje o tym, czy odpowiedź jest jeszcze przydatna, czy już nieaktualna.
Pomagają tu dwa pojęcia. Przepustowość to liczba klatek, które system przetworzy w ciągu sekundy. Opóźnienie (latencja) to czas obsługi jednej klatki – od chwili, gdy światło pada na matrycę, do chwili, gdy wynik jest gotowy. Przetwarzanie kilku klatek równolegle może zwiększyć przepustowość, ale żadnej pojedynczej klatki nie przyspieszy. Projektowanie systemów czasu rzeczywistego to przede wszystkim praca nad opóźnieniem: stały budżet na klatkę i jasna umowa, który etap może zużyć jaką jego część.
Wyniki zamiast pikseli
Drugie ograniczenie to łącze. Jeden nieskompresowany strumień Full HD – 1920 × 1080 pikseli, 8 bitów na kanał koloru, 30 klatek na sekundę – to około 187 megabajtów na sekundę, czyli mniej więcej 1,5 gigabita na sekundę. Kompresja pomaga, ale kosztem mocy obliczeniowej i jakości obrazu, a ciągłe wideo i tak pozostaje jednym z najcięższych ładunków, jakie urządzenie może wysyłać.
Większość zastosowań nie potrzebuje samego wideo, tylko tego, co w nim widać. Planista ruchu potrzebuje liczby obiektów każdej klasy, w każdym kierunku i w każdym kwadransie. Jeśli urządzenie policzy odpowiedź tam, gdzie powstaje obraz, siecią płynie garść liczb zamiast strumienia pikseli.
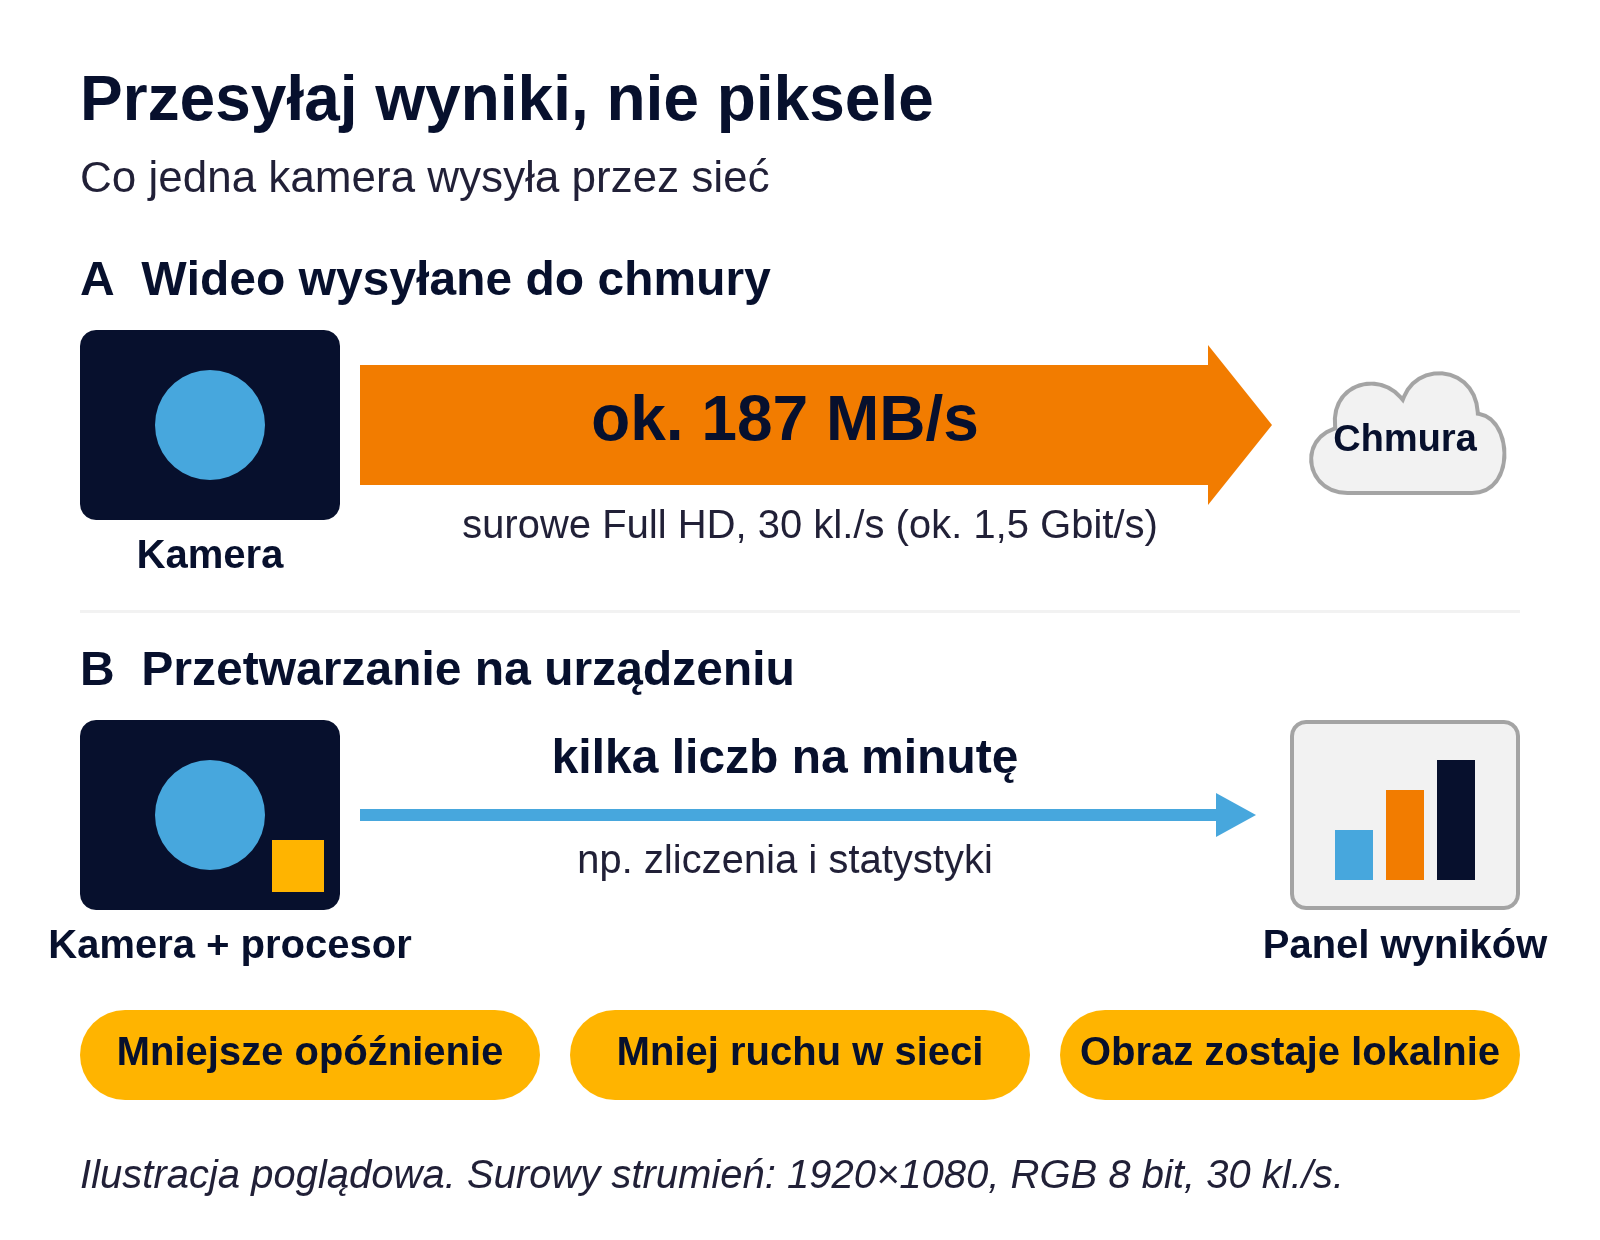
Surowe wideo Full HD a wyniki policzone na urządzeniu (schemat ilustracyjny)
Przetwarzanie na brzegu sieci (edge), czyli na samym urządzeniu albo tuż obok niego, daje trzy korzyści opisywane w badaniach nad edge computingiem:
- Krótszy czas reakcji. Wynik nie czeka, aż dane dotrą do centrum danych i wrócą.
- Mniejsze obciążenie sieci. Kilka liczb przejdzie przez słabe łącze komórkowe, które nigdy nie udźwignęłoby wideo – a urządzenia przy drogach często mają właśnie takie łącze.
- Prywatność. Obraz, który nigdy nie opuszcza urządzenia, nie wycieknie z serwera i nie zostanie użyty do innego celu.
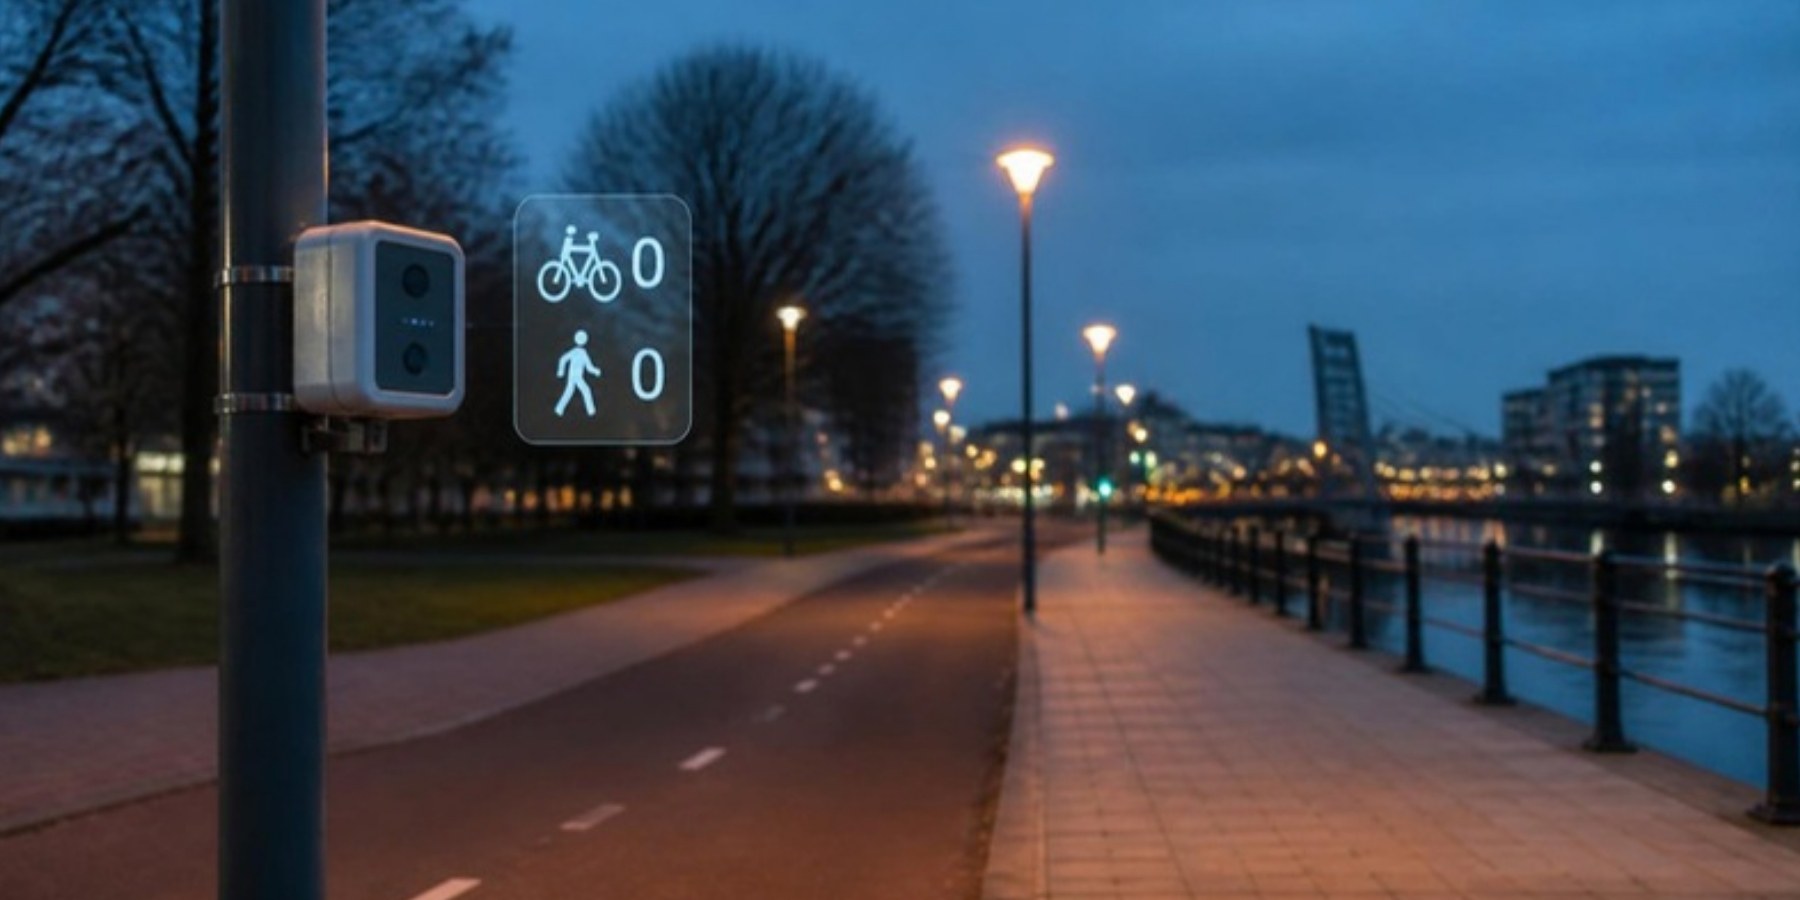
Wszystkie trzy korzyści zobaczyliśmy w projekcie badawczym zakończonym w 2024 r., poświęconym kamerom AI do zbierania danych o mobilności aktywnej. Nagrywanie i streaming działały na kamerze, modele detekcji dobraliśmy i wdrożyliśmy na jej własnym procesorze wizyjnym, a z urządzenia wychodziły wyłącznie anonimowe statystyki. Opisaliśmy ten projekt w artykule Edge AI w mobilności: liczenie pieszych i rowerzystów. Nasz pierwszy demonstrator kamery AI powstał w 2021 roku.
Edge nie jest za darmo: urządzenie potrzebuje wystarczającej mocy obliczeniowej, a model musi się w niej zmieścić. Prawdziwe pytanie nie brzmi więc „edge czy chmura” w ogóle, tylko: które dane naprawdę muszą trafić do sieci?
Małe procesory, prawdziwe modele
Na serwerze wybór modelu często zaczyna się od tabeli wyników: bierze się najdokładniejszy model, który działa wystarczająco szybko na dostępnym GPU. Na urządzeniu kolejność jest odwrotna – najpierw jest sprzęt, a on decyduje, które modele w ogóle wchodzą w grę.
Kamera z edge AI uruchamia inferencję na własnym procesorze wizyjnym, więc każdy model trzeba przekonwertować do formatu, który ten procesor rozumie. W naszych projektach ten wymóg zawężał wybór dużo bardziej, niż sugerowały jakiekolwiek publikowane rankingi. Najnowsze architektury nie zawsze są obsługiwane. Cięższe modele nie okazywały się automatycznie lepsze, gdy musiały działać na urządzeniu – bo dokładniejszy model, który nie mieści się w budżecie klatki, daje mniej odpowiedzi i później.
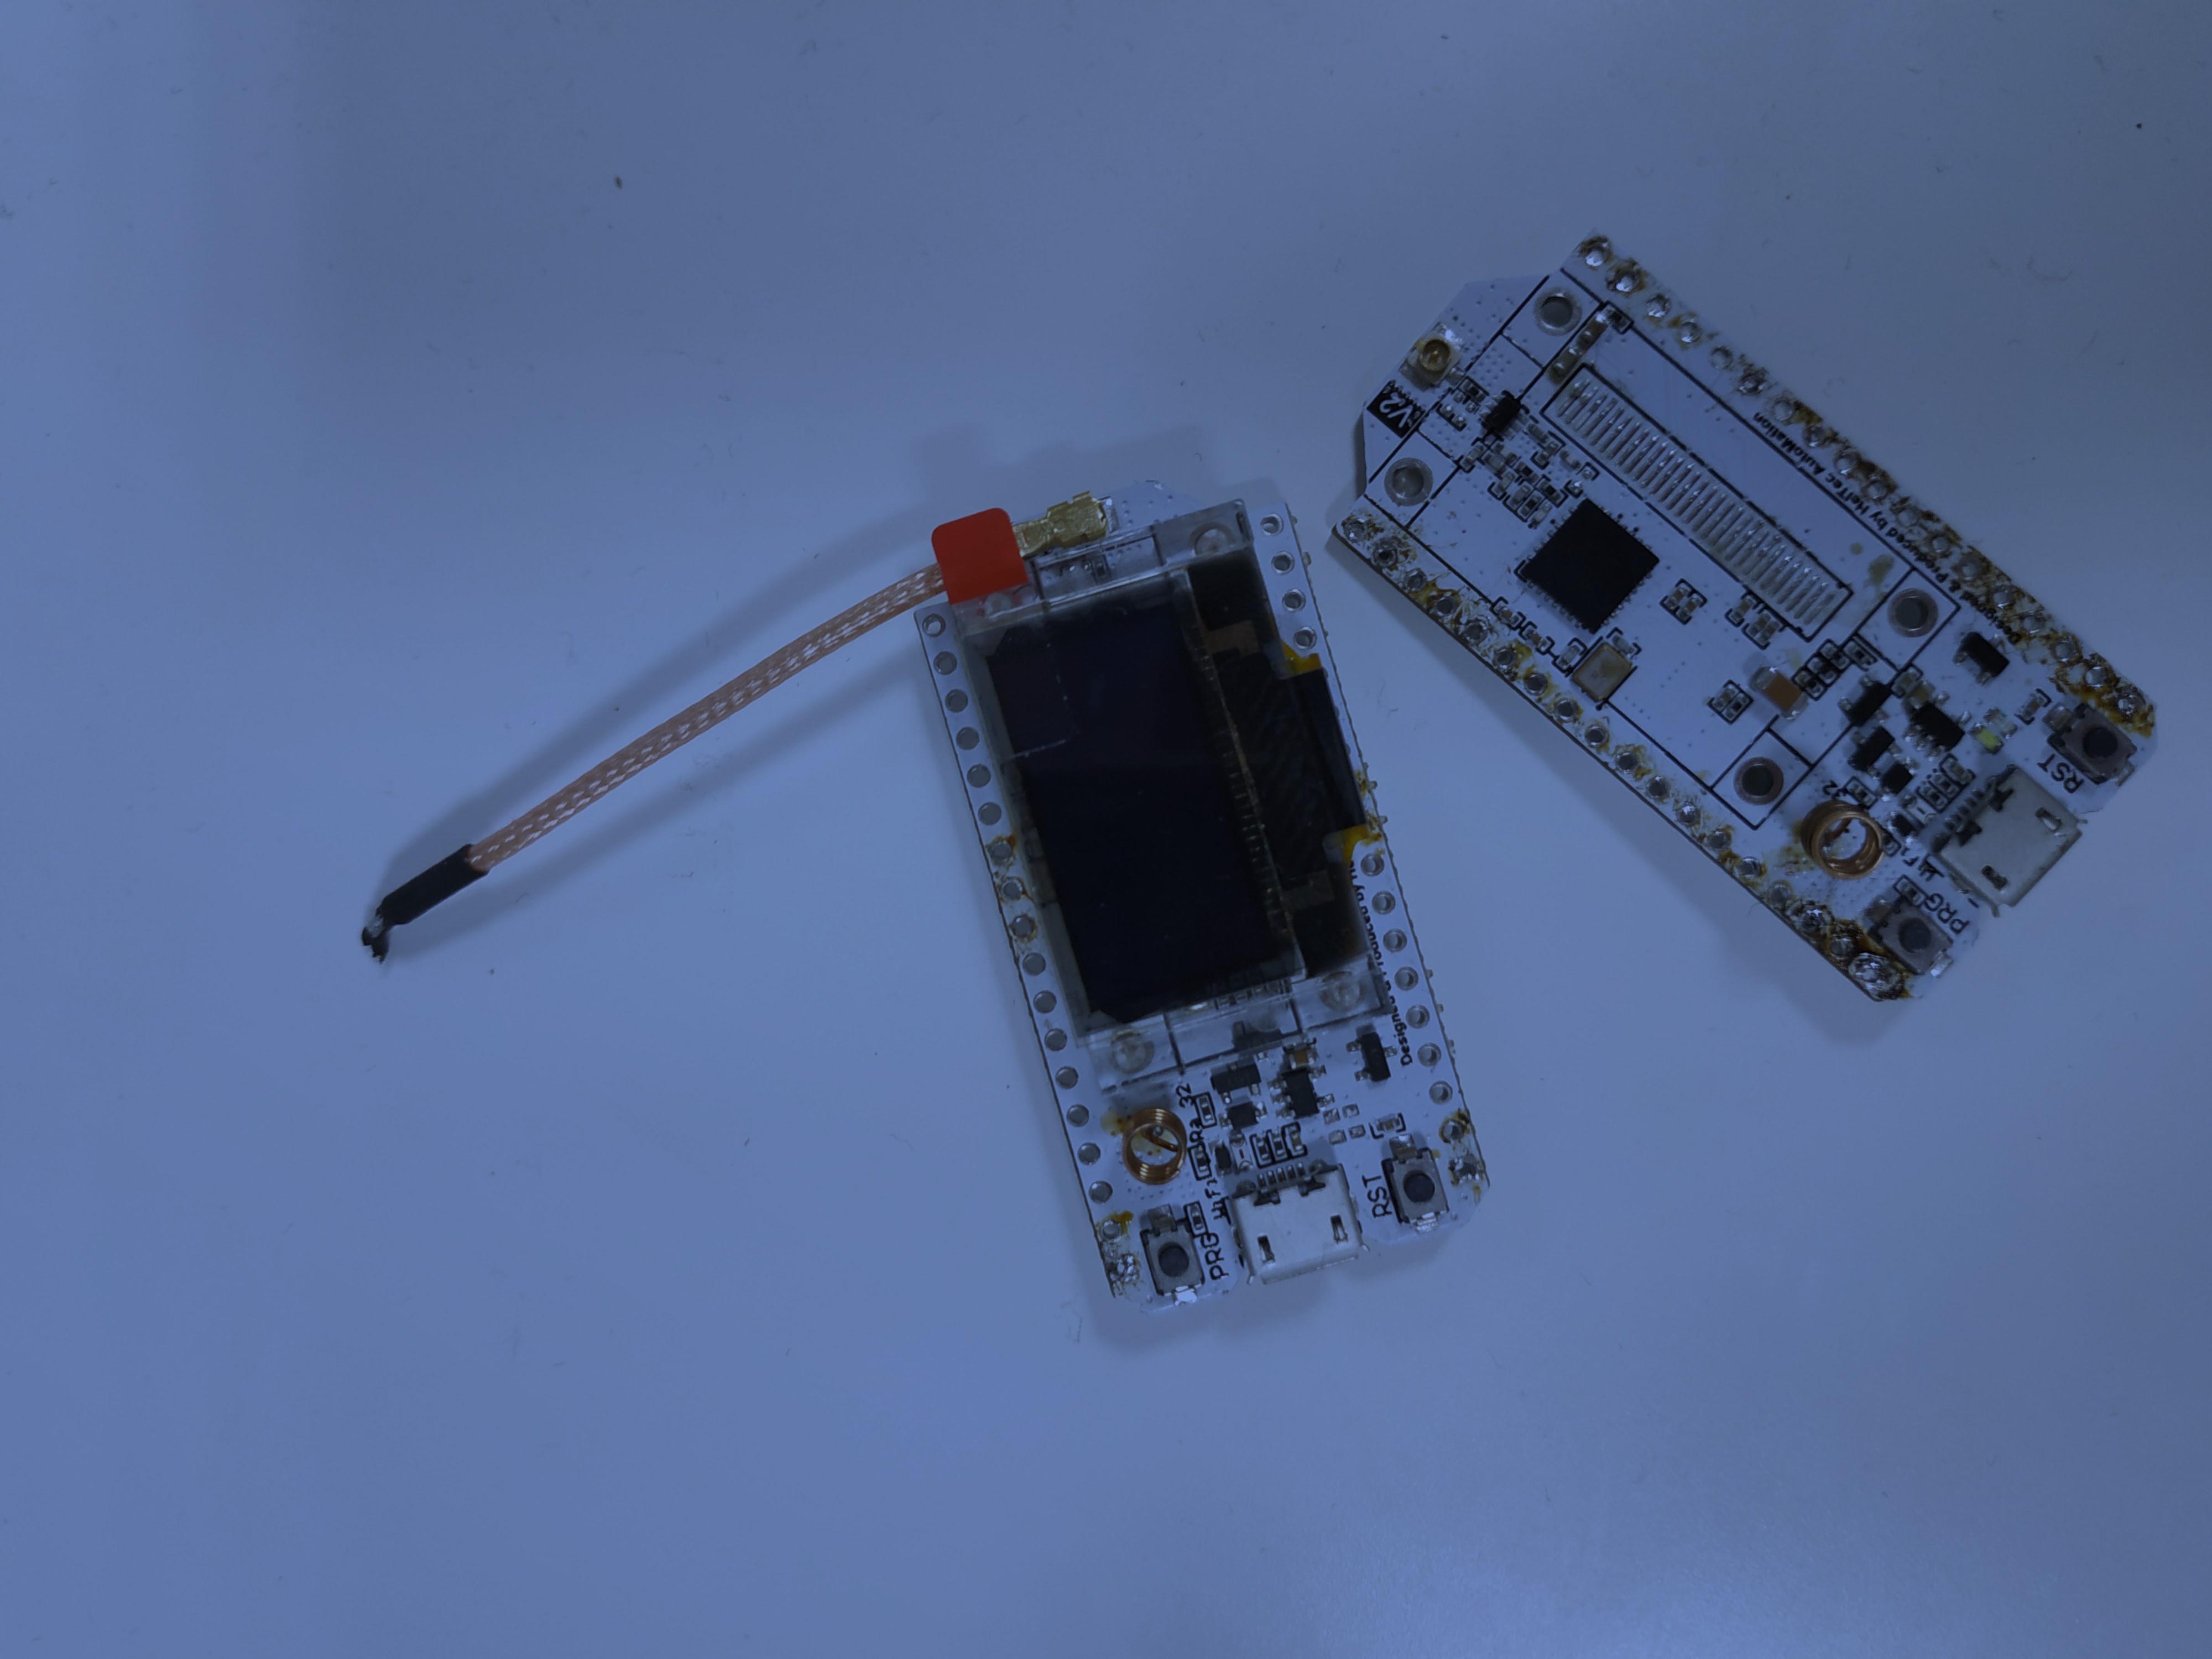
Ta sama logika dotyczy pamięci i energii. Urządzenia o niskim poborze mocy mają mało jednego i drugiego. Jeden z naszych czujników parkingowych zgłasza w czasie rzeczywistym, czy miejsce jest zajęte, a jego program mieści się w 2 KB pamięci. To przypadek skrajny, ale dobrze pokazuje nawyk, który popłaca w pracy z systemami wbudowanymi (embedded) w czasie rzeczywistym: ustalić, co urządzenie naprawdę musi liczyć, i zrezygnować z całej reszty. Więcej o procesorach, magistralach, zasilaniu i firmware pisaliśmy w artykule A co z firmware? Jak krok po kroku zbudować czujnik IoT.
W naszych projektach o wyborze modelu bardziej niż wyniki dokładności decydowało kilka pytań:
- Na jakim procesorze model będzie działał i jakie formaty modeli ten procesor obsługuje?
- Ile z budżetu klatki zostaje na inferencję po odliczeniu rejestracji, transferu i przygotowania obrazu?
- Jaki jest budżet energii – czy urządzenie jest zasilane z sieci, czy z baterii?
- Jakich klas obiektów i jakiej dokładności naprawdę wymaga dany przypadek użycia?
Opłaca się odpowiedzieć na nie, zanim zapadnie decyzja o sprzęcie. Z naszego doświadczenia konwersja nieobsługiwanego modelu potrafi pochłonąć więcej pracy niż wszystko inne w urządzeniu.
Fizyka też ma głos
Oprogramowanie można poprawić aktualizacją. Fizyki czujnika – nie, a daje ona o sobie znać w każdym systemie czasu rzeczywistego, który wychodzi poza laboratorium.
Migawka rolkowa (rolling shutter). Wiele matryc naświetla obraz wiersz po wierszu, a nie cały naraz. Gdy scena albo kamera szybko się porusza, proste linie się pochylają, bo dół klatki został zarejestrowany odrobinę później niż góra. Migawka globalna (global shutter) naświetla wszystkie wiersze w tej samej chwili i usuwa to pochylenie.
Rozmycie ruchu. Migawka globalna nie rozwiązuje wszystkiego. Jeśli czas naświetlania jest za długi w stosunku do prędkości ruchu, obraz i tak będzie rozmyty, a żaden model nie odtworzy szczegółów, których matryca nigdy nie zarejestrowała. Najbardziej odczuwa się to wtedy, gdy porusza się sama kamera, na przykład zamontowana na pojeździe albo dronie.
Dryf. Czujniki ruchu mierzą przyspieszenie i obrót, a nie położenie. Mały, stały błąd akcelerometru nie pozostaje mały: po dwukrotnym scałkowaniu, gdy z przyspieszenia wylicza się przebytą drogę, daje błąd rosnący z kwadratem czasu. Dlatego czujniki ruchu niemal zawsze łączy się z innym źródłem danych.
Czujnik nie do tego zadania. W jednym z naszych projektów czujników parkingowych realnym pytaniem projektowym było to, czy mierzyć światło, czy odległość. Oba rodzaje czujników reagują na co innego, a czujnik, który mierzy niewłaściwą wielkość, dostarcza dane czyste, regularne – i błędne.
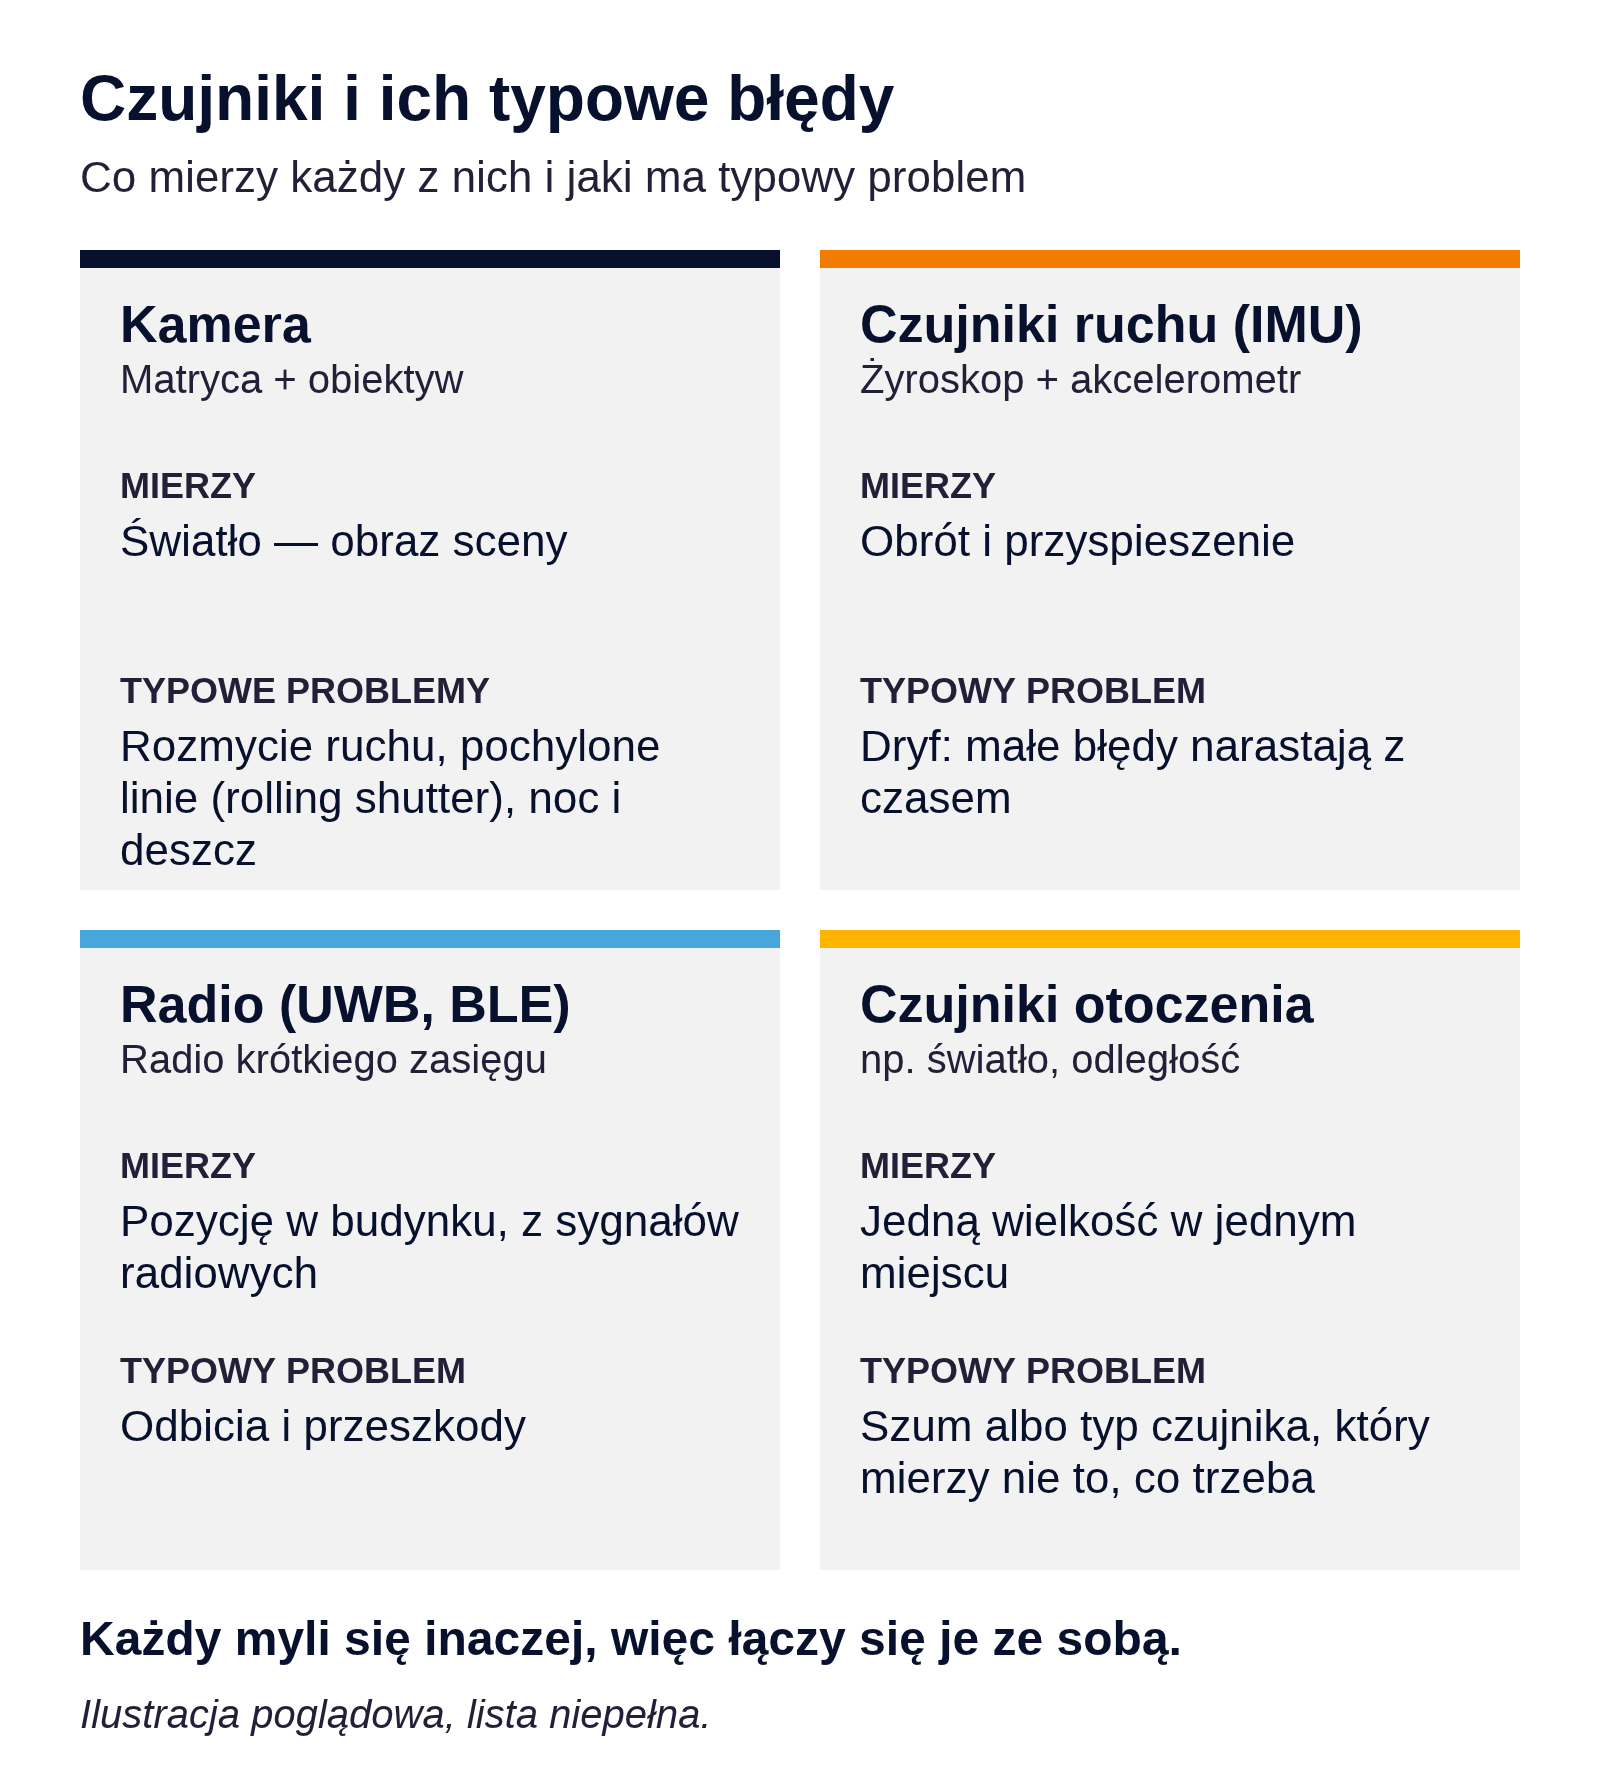
Co mierzą popularne czujniki i jak zwykle zawodzą (schemat ilustracyjny)
Ta sama chwila, dwa zegary. Każdy czujnik ma własny zegar. W czasie rzeczywistym dane z kamery i czujników ruchu łączy się od razu, więc przesunięcie między zegarami trzeba znać przed połączeniem danych, a nie korygować po fakcie. Metody synchronizacji różnią się o rzędy wielkości: NTP zwykle utrzymuje zegary w granicach milisekund, a PTP (IEEE 1588) w sieci lokalnej schodzi poniżej mikrosekundy ze sprzętowym znakowaniem czasu. Kalibracja kamera–IMU wyznacza to przesunięcie czasowe razem z wzajemnym położeniem czujników. Zetknęliśmy się z tym przy stanowisku wideo-EEG, które nagrywa obraz z dwóch kamer razem z sygnałem.
Źródła, które zawodzą inaczej
Żaden czujnik nie jest dobry we wszystkim. Kamera widzi dużo, ale gorzej radzi sobie w ciemności, a przy szybkim ruchu rozmywa obraz. Czujnik ruchu reaguje natychmiast, ale dryfuje. Pozycjonowanie radiowe daje zewnętrzny punkt odniesienia, ale cierpi na odbicia sygnału. Czujniki środowiskowe są zaszumione. Najważniejsze jest to, że każdy z nich zawodzi w inny sposób – więc jeden może uzupełniać słabości drugiego.
Klasycznym sposobem łączenia takich danych jest filtr Kalmana, opublikowany w 1960 roku i do dziś jedno z podstawowych narzędzi inżyniera. Jego idea mieści się w dwóch krokach. Najpierw przewidywanie: na podstawie wiedzy o tym, jak zachowuje się system, filtr szacuje jego następny stan. Potem korekta: gdy przychodzi pomiar, filtr przesuwa oszacowanie w jego stronę i ufa każdemu źródłu tym bardziej, im mniejsza jest jego niepewność. Dokładny pomiar mocno przyciąga oszacowanie, zaszumiony tylko lekko je przesuwa. Filtr działa rekurencyjnie, krok po kroku, a tego właśnie potrzebuje system czasu rzeczywistego: nigdy nie musi przeglądać całej historii od początku.
Mówiąc prościej: szybki, ale dryfujący czujnik wypełnia luki między wolniejszymi, pewniejszymi pomiarami, a te regularnie ściągają oszacowanie z powrotem, zanim dryf urośnie. Prawdziwa inżynieria zaczyna się przy modelowaniu każdego czujnika – i w każdym produkcie wygląda to inaczej.
Tę samą zasadę stosujemy w projektach z zakresu lokalizacji i śledzenia zasobów. W pozycjonowaniu w budynkach nasze rozwiązanie UWB działało z dokładnością 5–10 cm, a śledzenie zasobów łączy pozycjonowanie z innymi czujnikami umieszczonymi na śledzonym obiekcie. W analityce ruchu osób ludzi można liczyć kamerami, czujnikami 3D albo czujnikami termicznymi – właściwy wybór zależy od przestrzeni, oświetlenia i tego, do czego mają służyć dane. Przegląd tych technologii, od prostych czujników z wiązką po kamery, przygotowaliśmy w artykule Każdy się liczy: kilka słów o analityce ruchu osób.
Teren wygrywa z benchmarkiem
Publikowane wyniki mierzy się na publicznych zbiorach danych, w warunkach, które te zbiory zawierają. Prawdziwa instalacja dokłada własne: noc, deszcz, niską rozdzielczość, tłum i miejsce montażu, którego nikt nie przewidział. W naszych projektach te czynniki zmieniały wyniki w takim samym stopniu jak różnice między modelami w tabeli benchmarku.
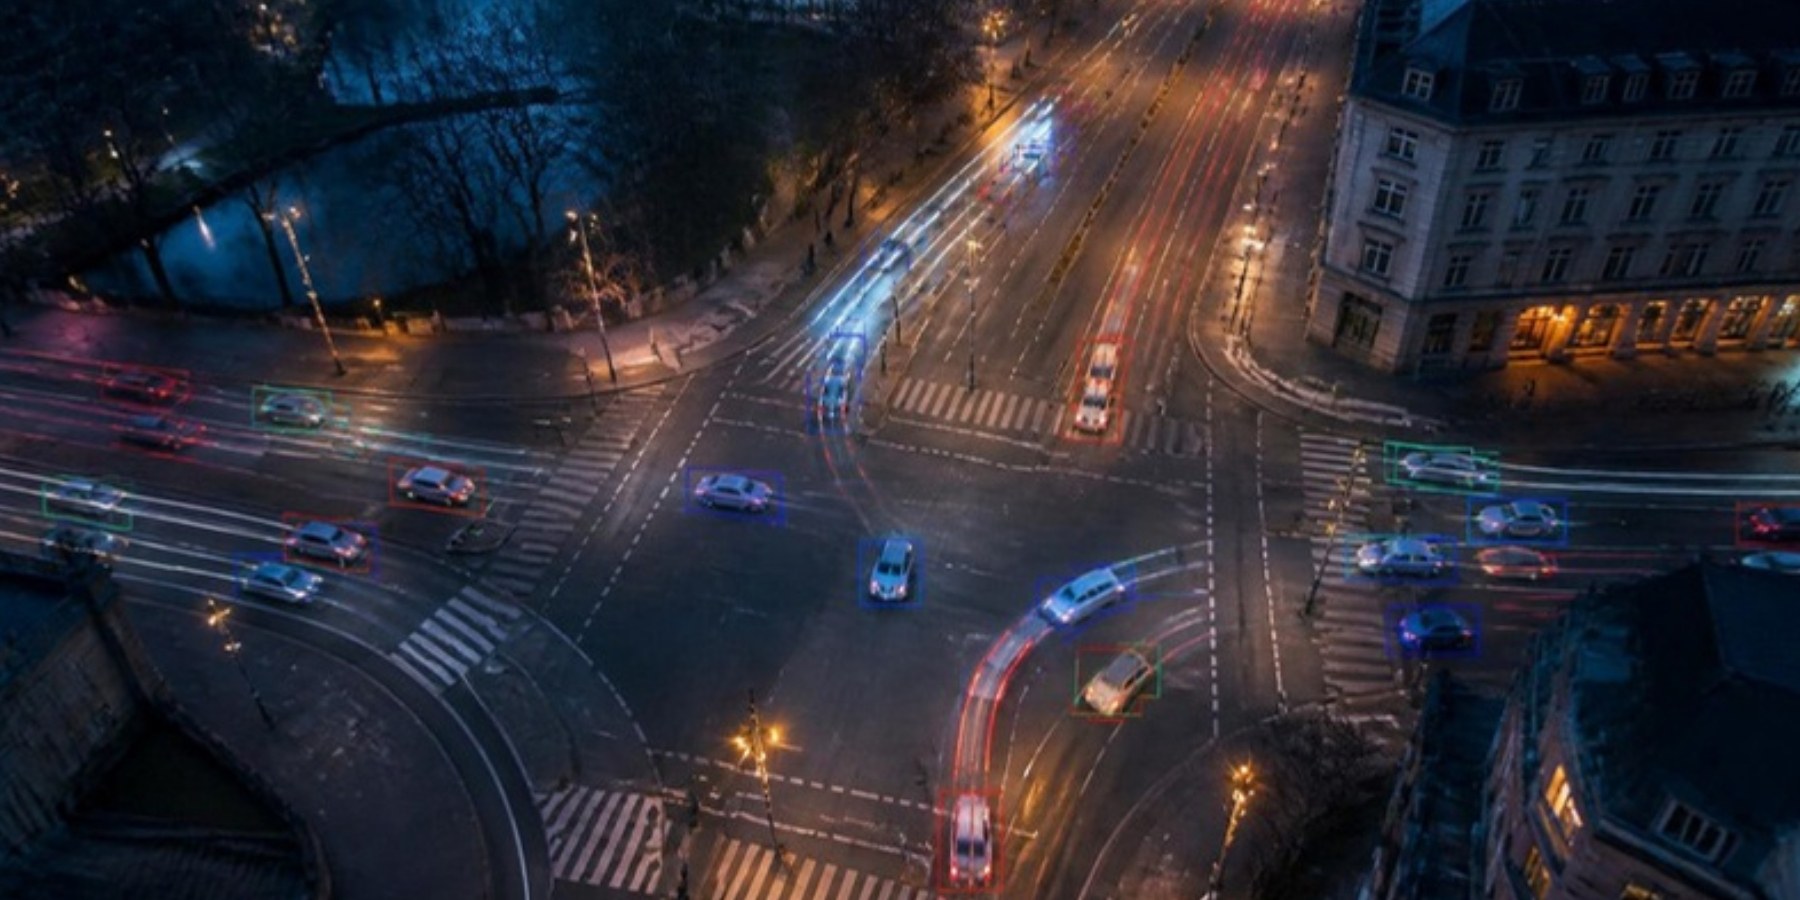
Nasze testy kamer AI w terenie pokazały to bardzo konkretnie. Przy małym ruchu lekki detektor z prostym filtrowaniem wypadał blisko ręcznego liczenia. W godzinach szczytu, gdy przechodziły całe grupy, każdy model miał kłopoty: osoby zlewały się w jedną albo w ogóle znikały. Montaż znaczył tyle samo co model. Wyniki były najlepsze tam, gdzie ścieżki się nie krzyżowały, a ludzie nie zatrzymywali się na skraju pola widzenia; wysokość montażu też zmieniała wyniki, zwłaszcza w tłumie. Strojenie progu detekcji okazało się kompromisem, a nie rozwiązaniem: niższy próg znajdował więcej obiektów – i dużo więcej fałszywych.
Nauczyliśmy się, że system czasu rzeczywistego trzeba testować tam i tak, gdzie i jak będzie działał. U nas sprawdziło się kilka zasad:
- Najpierw nagranie, potem porównanie. Nagrywamy prawdziwy materiał w docelowym miejscu i uruchamiamy każdy model-kandydat na tym samym nagraniu. Porównywanie modeli z różnych dni albo różnych scen porównuje pogodę, a nie modele. Na kamerach edge wbudowaliśmy w tym celu w urządzenie nagrywanie i odtwarzanie, bo detekcja normalnie działa na strumieniu na żywo.
- Ręczne liczenie jako odniesienie. W zadaniach liczenia naszym punktem odniesienia jest ręczne policzenie obiektów na tym samym nagraniu. To żmudne, ale tylko tak poznaje się rzeczywisty błąd.
- Wspólna miara. Standardową miarą jakości detekcji jest średnia precyzja (mAP) w definicji przyjętej dla publicznego zbioru COCO. Detekcja liczy się jako trafna, gdy przewidziana ramka wystarczająco pokrywa się z rzeczywistym obiektem – mierzy się to wskaźnikiem IoU (intersection over union). COCO mAP uśrednia precyzję dla dziesięciu progów IoU, od 0,50 do 0,95 co 0,05, więc nagradza modele, które lokalizują obiekty dokładnie, a nie tylko z grubsza.
- To, czego potrzebuje zastosowanie. mAP mówi, jak dobrze model znajduje obiekty na pojedynczych obrazach. Aplikacja licząca potrzebuje też poprawnej liczby w czasie, w każdym kierunku, przy małym i dużym ruchu. Liczą się obie wartości, a nie zawsze są ze sobą zgodne.
- Spokojne i szczytowe godziny. Na pustym chodniku każdy model wygląda dobrze. Testujemy zarówno przy małym, jak i przy dużym ruchu, a w planie testów jest też miejsce na noc i złą pogodę.
- Testy także po pierwszym sukcesie. Systemy czasu rzeczywistego się zmieniają: aktualizacje firmware, nowe modele, kamera przewieszona w inne miejsce. Prowadzimy testy manualne i automatyczne, z raportem z testów na każdym etapie – dzięki nim widać, czy zmiana, która pomaga w jednym miejscu, nie psuje czegoś w innym.
Benchmarki dobrze sprawdzają się przy wyborze krótkiej listy kandydatów. Decyzja należy do testu w terenie.
Od studium wykonalności do wdrożenia
Projekty przetwarzania obrazu w czasie rzeczywistym rzadko upadają przez model. Z naszego doświadczenia wynika, że problemy pojawiają się wcześniej: przy dostępie do danych, przy kosztach, których nikt nie zaplanował, albo przy pytaniu, kto będzie obsługiwał system. Dlatego pracujemy w trzech krokach.
1. Studium wykonalności. Zanim zacznie się budowa, sprawdzamy, czy problem w ogóle wymaga AI, jakie dane są dostępne, ile system będzie kosztował w budowie i utrzymaniu oraz czy przetwarzanie powinno odbywać się na brzegu sieci, czy w chmurze. Ochrona danych (RODO) i unijny AI Act są częścią projektu od początku, a nie audytem na końcu. Co obejmuje takie studium, opisaliśmy w artykule Zanim zbudujesz AI: wykonalność, dane, etyka i prawo.
2. Proof of concept na prawdziwych danych. PoC działa na danych z docelowego miejsca, w warunkach, z którymi system będzie się mierzył. W naszym studium wykonalności AI do analizy ruchu drogowego największymi barierami okazały się dostęp do danych i model eksploatacji, a nie dokładność modelu. Wiele miast nie daje bezpośredniego dostępu do strumieni ze swoich kamer, a niektóre organizacje mogą obsługiwać takie systemy wyłącznie własnym personelem. Jedno i drugie tanio sprawdzić na początku, a drogo odkryć pod koniec.
3. Wdrożenie na urządzeniu, z testami w terenie. Docelowy system działa tam, gdzie powstaje obraz. Dla nas oznacza to dobór sprzętu z myślą o modelach, wbudowanie w urządzenie nagrywania i odtwarzania, żeby dało się je testować, oraz testy w terenie, w prawdziwym miejscu montażu, z porównaniem do danych referencyjnych.
Ograniczenia czasu rzeczywistego dotykają każdej warstwy, dlatego cały łańcuch obejmujemy jednym zespołem: firmware i elektronikę, protokoły komunikacyjne takie jak UWB, LoRaWAN, RFID i ZigBee, a nad nimi modele AI. Obie strony opisujemy szerzej w usługach Internet rzeczy (IoT) i Tworzenie rozwiązań AI.
Najważniejsze wnioski
- Budżet czasu na klatkę. Przy 30 klatkach na sekundę wszystkie etapy, od rejestracji po decyzję, dzielą 33 milisekundy. O tym, czy system nadąża, decydują klatki spóźnione, a nie średnia.
- Wyniki zamiast pikseli. Surowe wideo Full HD to około 187 megabajtów na sekundę. Gdy odpowiedź liczy samo urządzenie, a siecią płynie kilka liczb, reakcja jest szybsza, sieć mniej obciążona, a obraz zostaje na miejscu.
- Czujniki, które zawodzą inaczej. Kamera rozmywa obraz, czujnik ruchu dryfuje, a pozycjonowanie radiowe cierpi na odbicia. Połączone – na przykład filtrem Kalmana – źródła uzupełniają nawzajem swoje słabości.
- Teren ważniejszy niż benchmark. Tłum i miejsce montażu zmieniały nasze wyniki w takim samym stopniu jak wybór modelu, dlatego testujemy na nagraniach z docelowego miejsca.
Jeśli pracujesz nad urządzeniem, które ma widzieć, mierzyć i reagować w czasie rzeczywistym, chętnie o tym porozmawiamy – napisz do nas.
Zapytaj o wycenę lub poradę

Przeanalizujmy razem koncepcję Twojego projektu i to, na jakim jest etapie.

Otrzymasz od nas wstępną propozycję zakresu projektu oraz szacunek czasu i kosztów.

Konsultacje są objęte umową NDA.