
19. Oktober 2026
Bild- und Sensordaten in Echtzeit
In diesem Artikel:
Was „Echtzeit“ wirklich bedeutetErgebnisse statt PixelKleine Prozessoren, echte ModelleDie Physik redet mitQuellen, die unterschiedlich versagenDas Feld schlägt den BenchmarkVon der Machbarkeitsstudie zum RolloutDas Wichtigste in KürzeBei 30 Bildern pro Sekunde bleiben einem Gerät 33 Millisekunden, um jedes Bild aufzunehmen, weiterzuleiten, zu verarbeiten und darauf zu reagieren – dann beginnt alles von vorn. Was die Verarbeitung von Bild- und Sensordaten in Echtzeit schwierig macht und was wir beim Bau von Kameras, Sensoren und Edge-KI-Geräten gelernt haben.
Was „Echtzeit“ wirklich bedeutet
„Echtzeit“ wird oft als „schnell“ verstanden. In der Bildverarbeitung bedeutet es etwas Strengeres: pünktlich, und zwar jedes Mal. Eine Kamera mit 30 Bildern pro Sekunde liefert alle 33,3 Millisekunden ein neues Bild (1000 geteilt durch die Bildrate). Bei 60 Bildern pro Sekunde schrumpft das Zeitfenster auf 16,7 Millisekunden. Alles, was mit einem Bild geschieht, muss in dieses Fenster passen – sonst ist das nächste Bild schon da, bevor das vorherige fertig ist.
Dieses Fenster teilen sich alle Schritte. Der Sensor muss belichtet und ausgelesen werden, das Bild muss in den Speicher gelangen und für das Modell vorbereitet werden, das Modell muss es analysieren, und aus dem Ergebnis muss eine Entscheidung oder eine Nachricht werden. Keiner dieser Schritte bekommt eigene 33 Millisekunden. Dauert die Vorbereitung länger als geplant, bleibt für die Inferenz weniger Zeit.
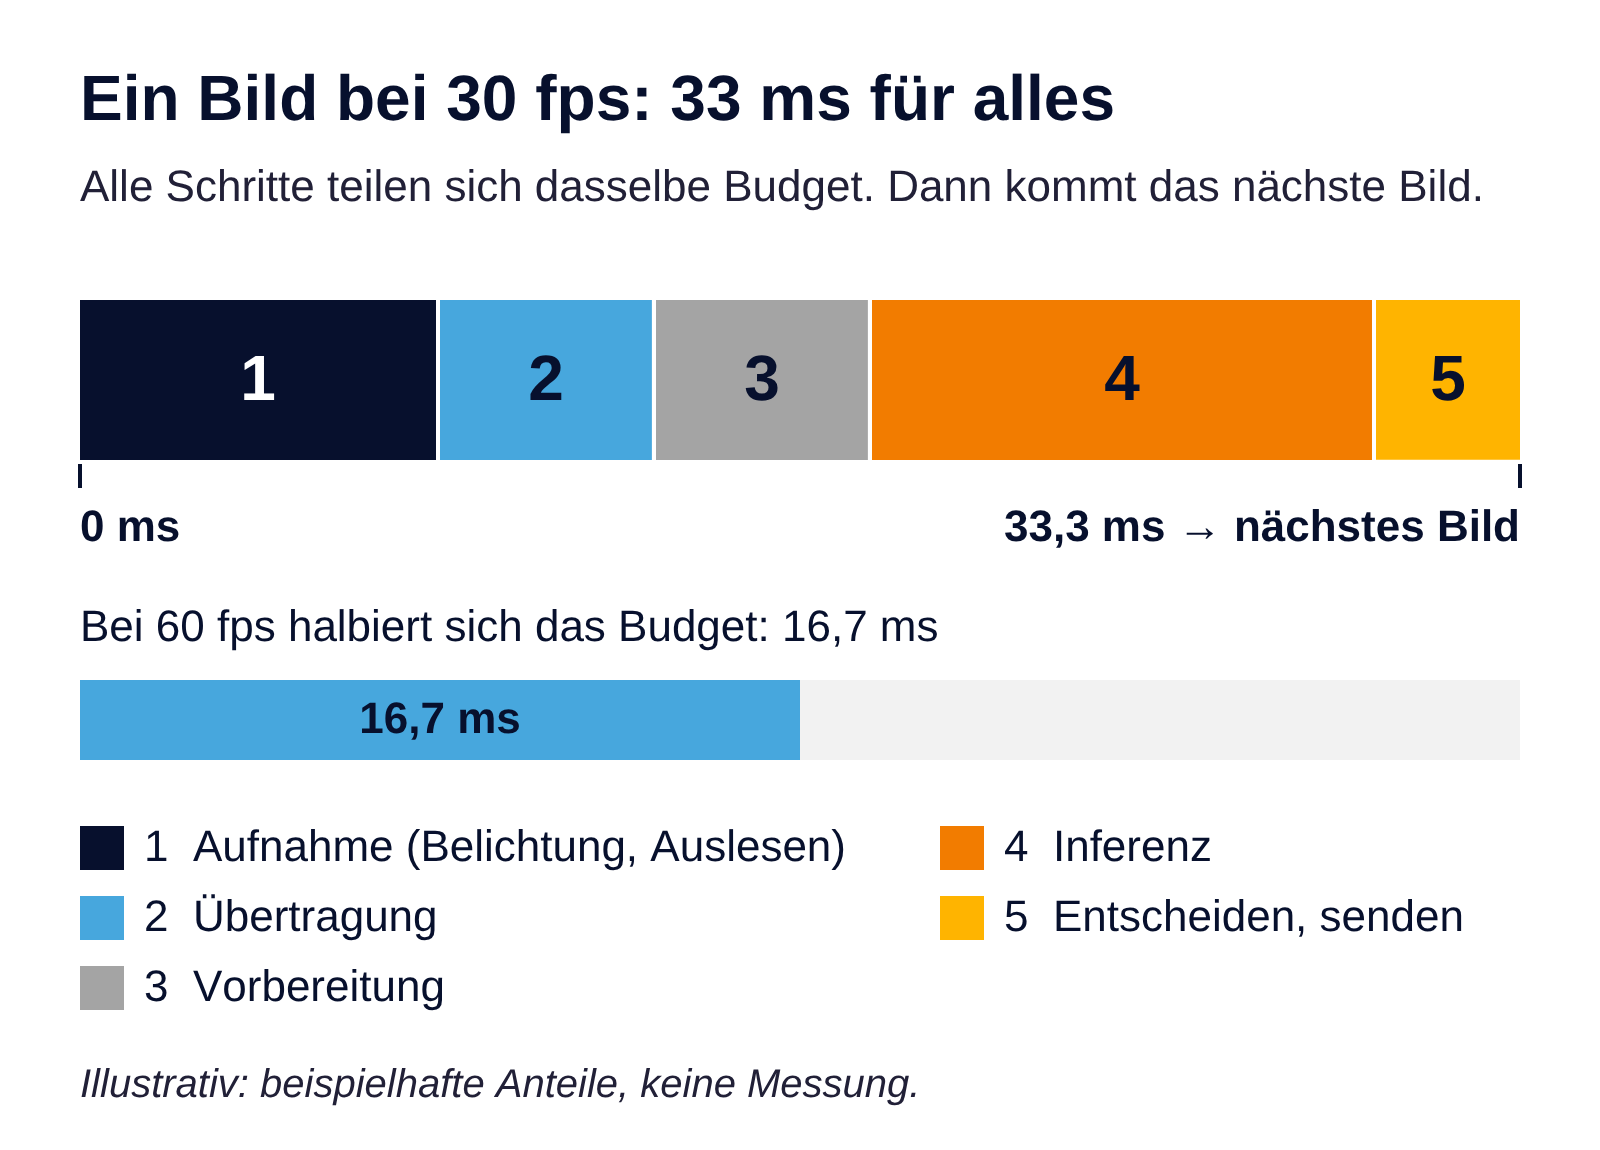
Das 33-ms-Budget eines Bildes bei 30 Bildern pro Sekunde (illustrative Darstellung)
Deshalb sagt eine Durchschnittsgeschwindigkeit wenig aus. Ein System, das die meisten Bilder deutlich innerhalb des Budgets verarbeitet, für ein gelegentliches Bild aber doppelt so lange braucht, ist kein System mit 30 Bildern pro Sekunde. Es verwirft Bilder oder bildet eine Warteschlange, und jedes weitere Bild in der Schlange wartet länger als das vorige. Für eine Statistik, die jede Viertelstunde aktualisiert wird, ist ein verspätetes Bild harmlos. Für alles, was auf das Kamerabild reagieren soll, entscheidet es darüber, ob eine Antwort noch nützt oder schon veraltet ist.
Zwei Begriffe helfen hier. Der Durchsatz gibt an, wie viele Bilder ein System pro Sekunde verarbeiten kann. Die Latenz ist die Zeit, die ein einzelnes Bild braucht – von dem Moment, in dem Licht auf den Sensor fällt, bis das Ergebnis vorliegt. Mehrere Bilder parallel zu verarbeiten, kann den Durchsatz erhöhen, macht aber kein einzelnes Bild schneller. Bei Echtzeitsystemen geht es vor allem um Latenz: ein festes Budget pro Bild und eine klare Vereinbarung, welcher Schritt wie viel davon verbrauchen darf.
Ergebnisse statt Pixel
Die zweite Grenze ist die Bandbreite. Ein einzelner unkomprimierter Full-HD-Stream – 1920 × 1080 Pixel, 8 Bit pro Farbkanal, 30 Bilder pro Sekunde – kommt auf etwa 187 Megabyte pro Sekunde, also rund 1,5 Gigabit pro Sekunde. Kompression hilft, kostet aber Rechenleistung und Bildqualität, und ein durchgehender Videostream bleibt eine der schwersten Lasten, die ein Gerät senden kann.
Die meisten Anwendungen brauchen das Video gar nicht. Sie brauchen, was darauf zu sehen ist. Wer Verkehr plant, braucht Zählungen pro Klasse, pro Richtung und pro Viertelstunde. Berechnet das Gerät die Antwort dort, wo das Bild entsteht, transportiert das Netz eine Handvoll Zahlen statt eines Pixelstroms.
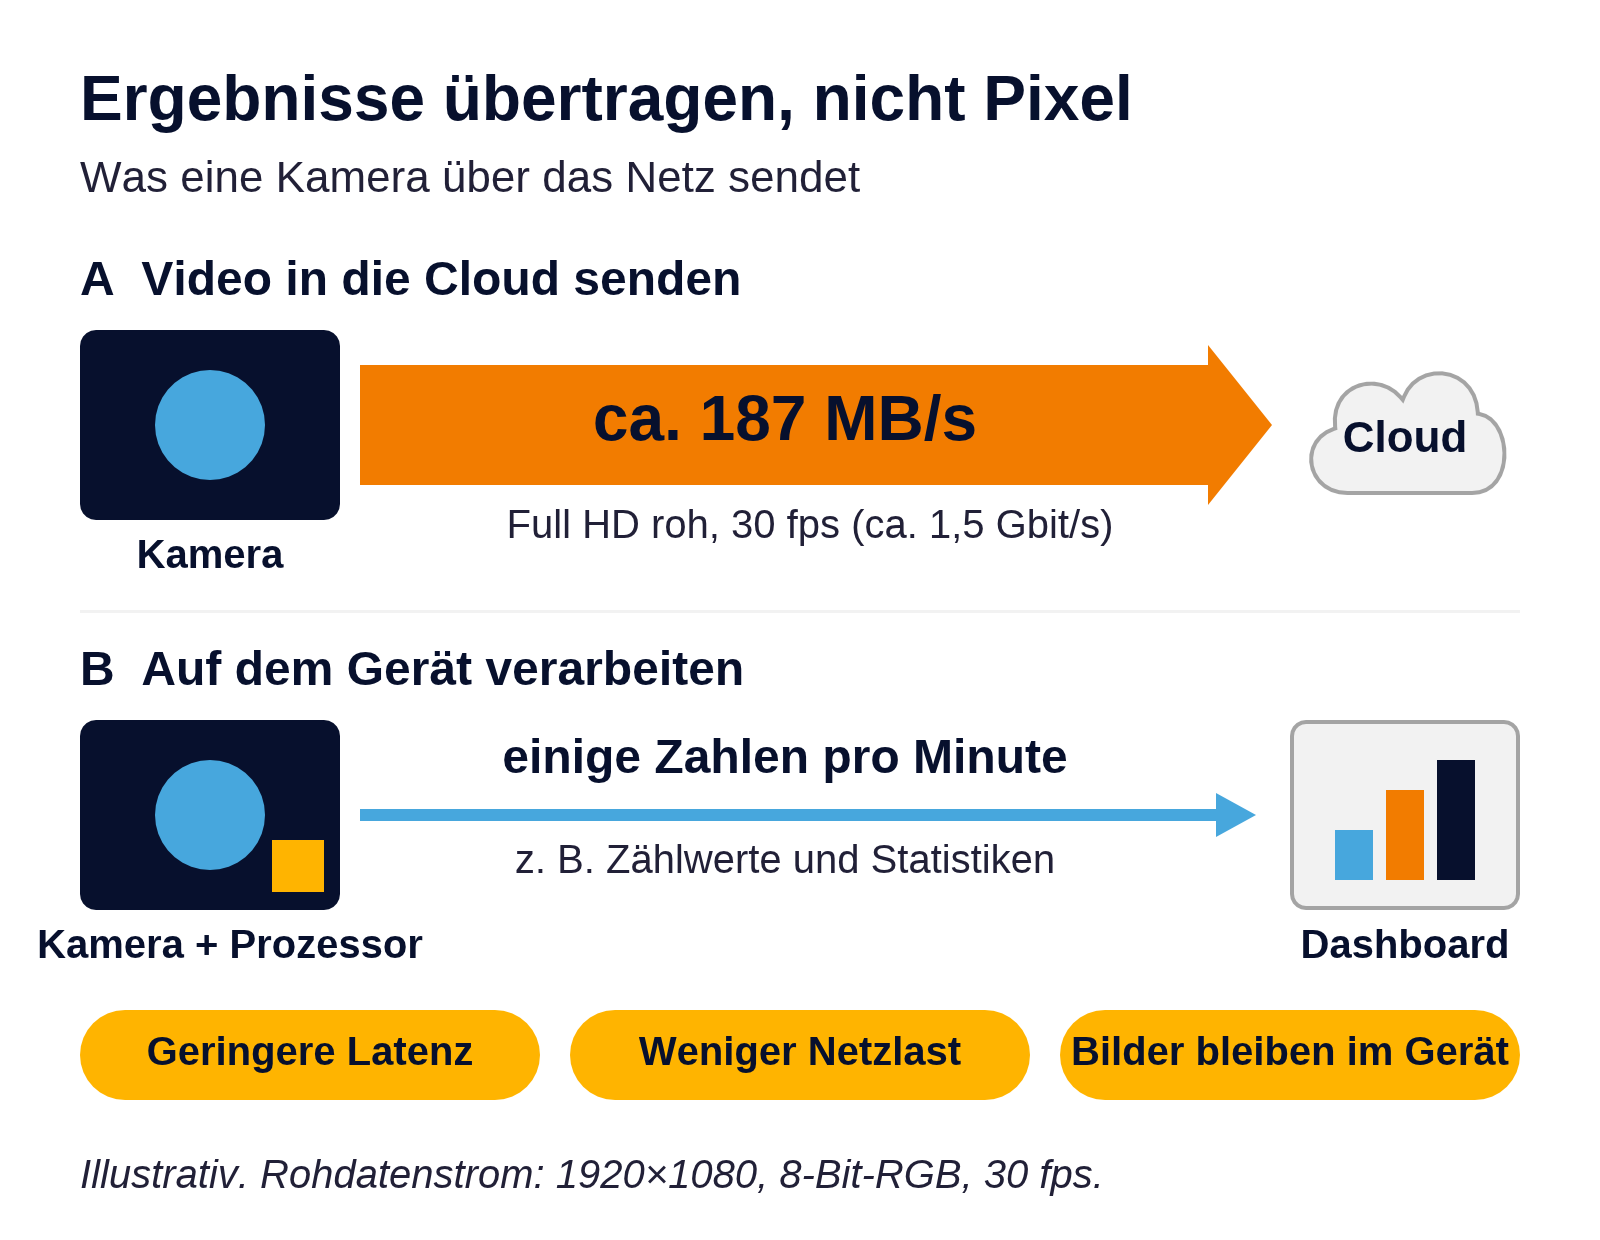
Rohes Full-HD-Video im Vergleich zu Ergebnissen, die auf dem Gerät berechnet werden (illustrative Darstellung)
Die Verarbeitung am Edge, also auf dem Gerät selbst oder direkt daneben, bringt drei Vorteile, die die Forschung zum Edge Computing beschreibt:
- Kürzere Reaktionszeit. Das Ergebnis wartet nicht auf den Weg zum Rechenzentrum und zurück.
- Weniger Last im Netz. Ein paar Zahlen passen durch eine schwache Mobilfunkverbindung, die nie ein Video tragen würde – und Geräte am Straßenrand haben oft genau so eine Verbindung.
- Datenschutz. Bilder, die das Gerät nie verlassen, können weder aus einem Server abfließen noch für andere Zwecke verwendet werden.
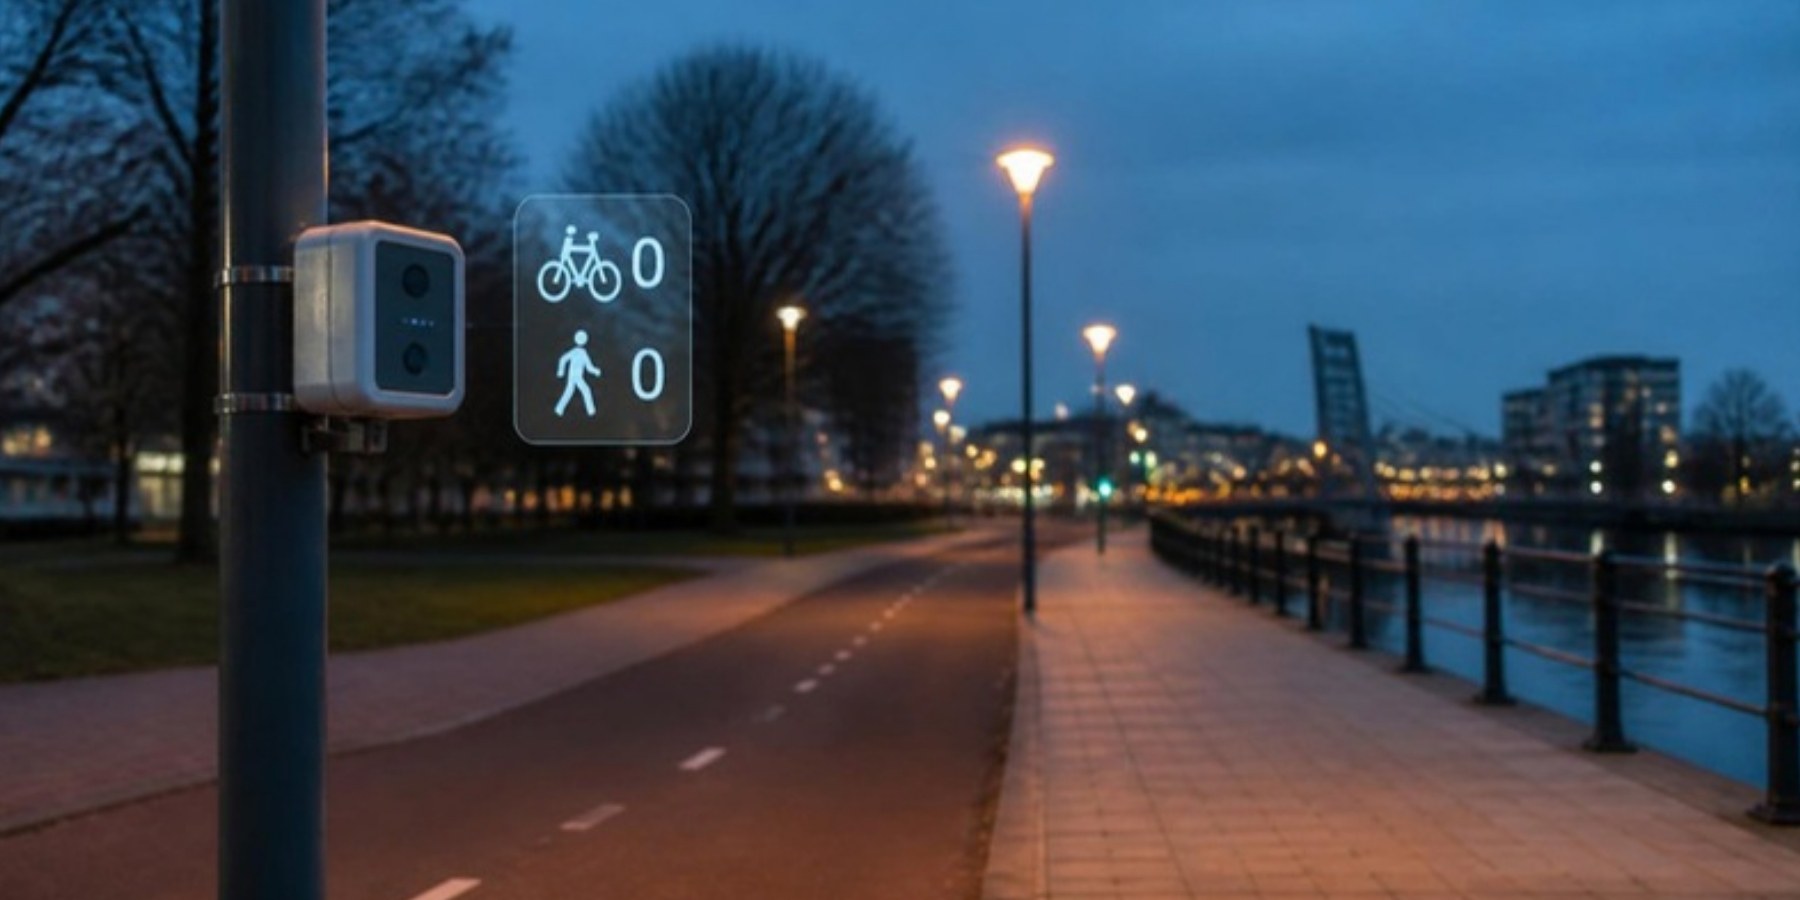
Alle drei Vorteile haben wir in einem 2024 abgeschlossenen Forschungsprojekt zu KI-Kameras für aktive Mobilität erlebt. Aufnahme und Streaming liefen auf der Kamera, die Erkennungsmodelle haben wir ausgewählt und auf dem eigenen Bildprozessor der Kamera ausgerollt, und nur anonyme Statistiken verließen das Gerät. Das Projekt beschreiben wir im Artikel Edge-KI für Mobilität: Fußgänger und Radfahrer zählen. Unseren ersten KI-Kamera-Demonstrator haben wir bereits 2021 gebaut.
Edge-Verarbeitung gibt es nicht umsonst: Das Gerät braucht genug Rechenleistung, und das Modell muss darauf passen. Die eigentliche Frage lautet also nicht „Edge oder Cloud“ im Allgemeinen, sondern: Welche Daten müssen wirklich über das Netz?
Kleine Prozessoren, echte Modelle
Auf einem Server beginnt die Modellwahl oft mit einer Benchmark-Tabelle: Man nimmt das genaueste Modell, das auf der vorhandenen GPU schnell genug läuft. Auf einem Gerät steht die Hardware am Anfang und entscheidet, welche Modelle überhaupt infrage kommen.
Eine Edge-KI-Kamera führt die Inferenz auf ihrem eigenen Bildprozessor aus, also muss jedes Modell in ein Format konvertiert werden, das dieser Prozessor versteht. In unseren Projekten hat diese Anforderung die Auswahl viel stärker eingeschränkt, als es veröffentlichte Rankings vermuten ließen. Die neuesten Architekturen werden nicht immer unterstützt. Schwerere Modelle waren auf dem Gerät nicht automatisch besser: Ein genaueres Modell, das das Budget pro Bild sprengt, liefert weniger Antworten, und die kommen später.
Dieselbe Logik gilt für Speicher und Energie. Geräte mit geringem Stromverbrauch haben von beidem wenig. Einer unserer Smart-Parking-Sensoren meldet in Echtzeit, ob ein Stellplatz belegt ist, und sein Programm passt in 2 KB Speicher. Ein Extremfall, aber er zeigt eine Haltung, die sich in der Embedded-Entwicklung in Echtzeit auszahlt: festlegen, was das Gerät wirklich berechnen muss, und alles andere weglassen. Mehr über Prozessoren, Busse, Stromversorgung und Firmware haben wir im Artikel Und die Firmware? So entsteht ein IoT-Sensor beschrieben.
In unseren Projekten haben einige Fragen die Wahl stärker geprägt als Genauigkeitswerte:
- Auf welchem Prozessor läuft das Modell, und welche Modellformate unterstützt dieser Prozessor?
- Wie viel vom Budget pro Bild bleibt für die Inferenz, wenn Aufnahme, Übertragung und Vorbereitung abgezogen sind?
- Wie hoch ist das Energiebudget – hängt das Gerät am Stromnetz oder läuft es mit Batterie?
- Welche Objektklassen und welche Genauigkeit braucht der Anwendungsfall wirklich?
Es lohnt sich, diese Fragen zu klären, bevor die Hardware feststeht. Nach unserer Erfahrung kann es mehr Aufwand kosten, ein nicht unterstütztes Modell zu konvertieren, als alles andere am Gerät.
Die Physik redet mit
Software lässt sich per Update korrigieren. Die Physik eines Sensors nicht – und sie macht sich in jedem Echtzeitsystem bemerkbar, das das Labor verlässt.
Rolling Shutter. Viele Bildsensoren belichten das Bild Zeile für Zeile statt auf einmal. Bewegt sich die Szene oder die Kamera schnell, kippen gerade Linien, weil der untere Bildrand etwas später aufgenommen wurde als der obere. Ein Global Shutter belichtet alle Zeilen im selben Moment und beseitigt diese Schräglage.
Bewegungsunschärfe. Ein Global Shutter löst nicht alles. Ist die Belichtung für die Geschwindigkeit der Bewegung zu lang, wird das Bild trotzdem unscharf, und kein Modell kann Details zurückholen, die nie aufgenommen wurden. Am stärksten wirkt sich das aus, wenn sich die Kamera selbst bewegt, etwa auf einem Fahrzeug oder einer Drohne.
Drift. Bewegungssensoren messen Beschleunigung und Drehung, nicht die Position. Ein kleiner, konstanter Fehler im Beschleunigungssensor bleibt nicht klein: Zweimal integriert, um die zurückgelegte Strecke zu schätzen, ergibt er einen Fehler, der mit dem Quadrat der Zeit wächst. Deshalb werden Bewegungssensoren fast immer mit einer anderen Quelle kombiniert.
Der falsche Sensor für die Aufgabe. In einem unserer Projekte mit Parksensoren war eine echte Designfrage, ob Licht oder Abstand gemessen werden soll. Beide Sensorarten reagieren auf Unterschiedliches, und ein Sensor, der die falsche Größe misst, liefert saubere, regelmäßige und falsche Daten.
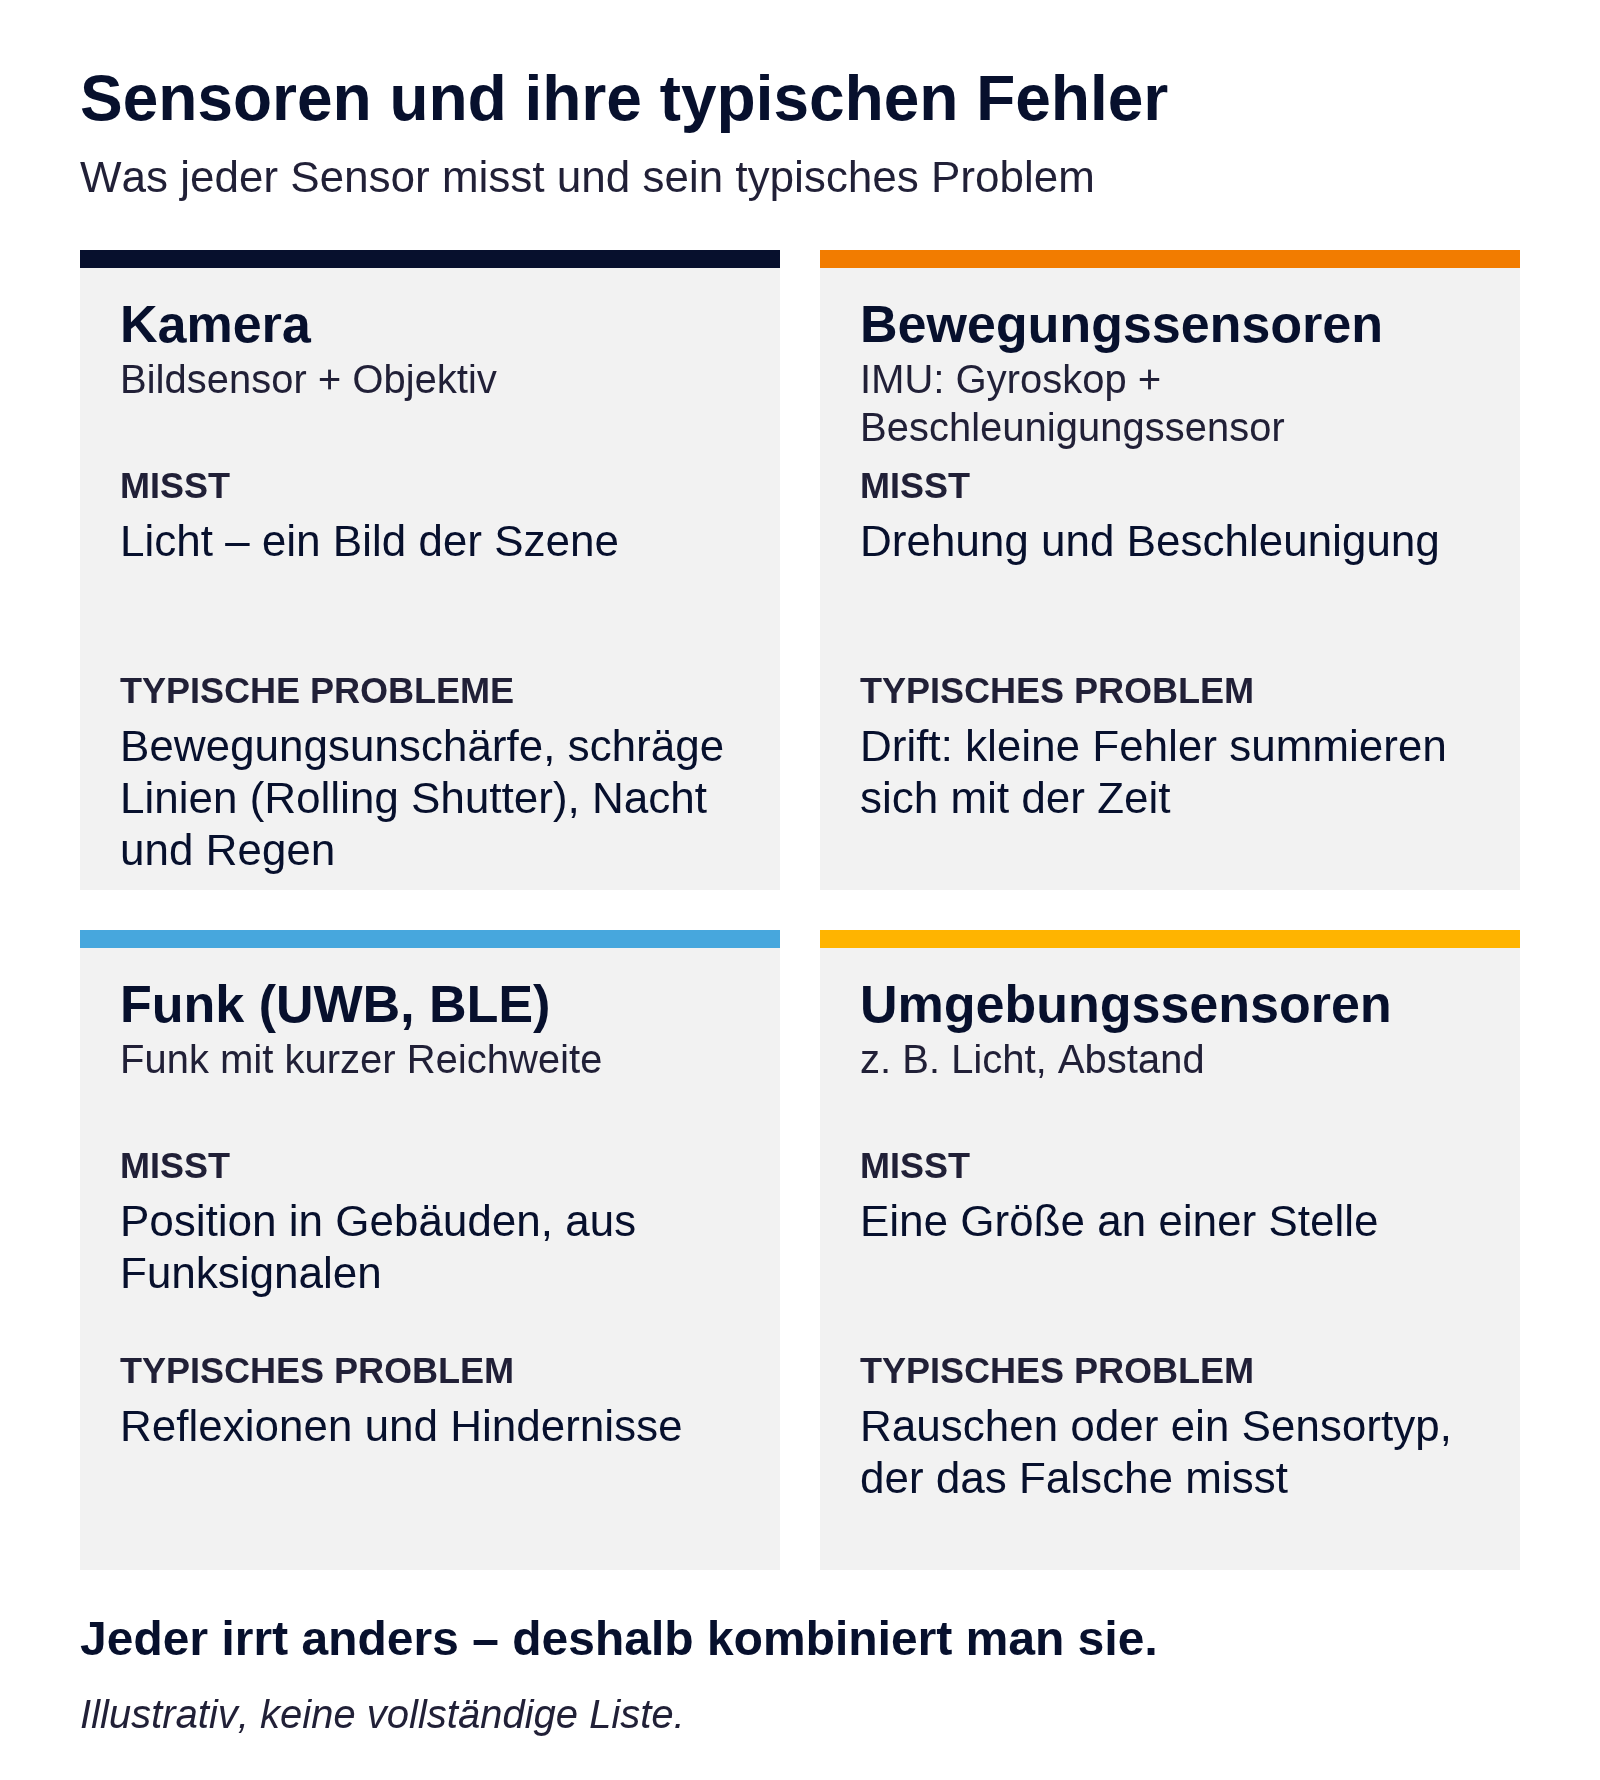
Was gängige Sensoren messen und wie sie typischerweise versagen (illustrative Darstellung)
Derselbe Moment, zwei Uhren. Jeder Sensor hat seine eigene Uhr. In Echtzeit werden Kamera- und Bewegungsdaten sofort zusammengeführt, deshalb muss der Versatz zwischen den Uhren vor dem Zusammenführen bekannt sein und darf nicht erst hinterher korrigiert werden. Die Verfahren unterscheiden sich um Größenordnungen: NTP hält Uhren meist im Millisekundenbereich, PTP (IEEE 1588) erreicht im lokalen Netz mit Hardware-Zeitstempeln weniger als eine Mikrosekunde. Die Kamera-IMU-Kalibrierung schätzt diesen Zeitversatz zusammen mit der relativen Lage der Sensoren. Uns ist das bei einem Video-EEG-Messplatz begegnet, der zwei Kameras zusammen mit dem Signal aufzeichnet.
Quellen, die unterschiedlich versagen
Kein Sensor ist in allem gut. Eine Kamera sieht viel, tut sich aber im Dunkeln schwer und liefert bei schneller Bewegung unscharfe Bilder. Ein Bewegungssensor reagiert sofort, driftet aber. Funkortung liefert einen externen Bezugspunkt, leidet aber unter Reflexionen. Umweltsensoren rauschen. Die nützliche Erkenntnis: Sie versagen auf unterschiedliche Weise, also kann einer die Schwächen des anderen ausgleichen.
Der klassische Weg, sie zu kombinieren, ist der Kalman-Filter – 1960 veröffentlicht und bis heute ein Arbeitspferd. Die Idee passt in zwei Schritte. Zuerst vorhersagen: Aus dem Wissen, wie sich das System verhält, wird sein nächster Zustand geschätzt. Dann korrigieren: Trifft eine Messung ein, wird die Schätzung in ihre Richtung verschoben, und jeder Quelle wird umso mehr vertraut, je geringer ihre Unsicherheit ist. Eine präzise Messung zieht die Schätzung stark zu sich, eine verrauschte schiebt sie nur ein wenig. Der Filter arbeitet rekursiv, Schritt für Schritt – genau das, was ein Echtzeitsystem braucht: Er muss nie die gesamte Vorgeschichte noch einmal durchgehen.
Einfach gesagt: Ein schneller, aber driftender Sensor füllt die Lücken zwischen langsameren, verlässlicheren Messungen, und diese ziehen die Schätzung regelmäßig zurück, bevor die Drift wächst. Wie jeder Sensor modelliert wird, ist die eigentliche Ingenieursarbeit – und die sieht bei jedem Produkt anders aus.
Dasselbe Prinzip nutzen wir im Bereich Standort- und Asset-Tracking. Bei der Indoor-Ortung arbeitete unsere UWB-Lösung mit einer Genauigkeit von 5–10 cm, und beim Asset-Tracking wird die Ortung mit weiteren Sensoren am verfolgten Objekt kombiniert. In der Besucheranalyse lassen sich Personen mit Kameras, 3D-Sensoren oder Wärmesensoren zählen; welche Lösung passt, hängt vom Raum, vom Licht und vom Zweck der Daten ab. Einen Überblick über diese Technologien, von einfachen Lichtschranken bis zu Kameras, geben wir in Jeder zählt: ein paar Worte zur Besucheranalyse.
Das Feld schlägt den Benchmark
Veröffentlichte Ergebnisse werden auf öffentlichen Datensätzen gemessen, unter den Bedingungen, die diese Datensätze enthalten. Eine echte Installation bringt eigene mit: Nacht, Regen, niedrige Auflösung, Menschenmengen und eine Montageposition, die niemand eingeplant hat. In unseren Projekten haben diese Faktoren die Ergebnisse ebenso stark verändert wie der Unterschied zwischen Modellen in einer Benchmark-Tabelle.
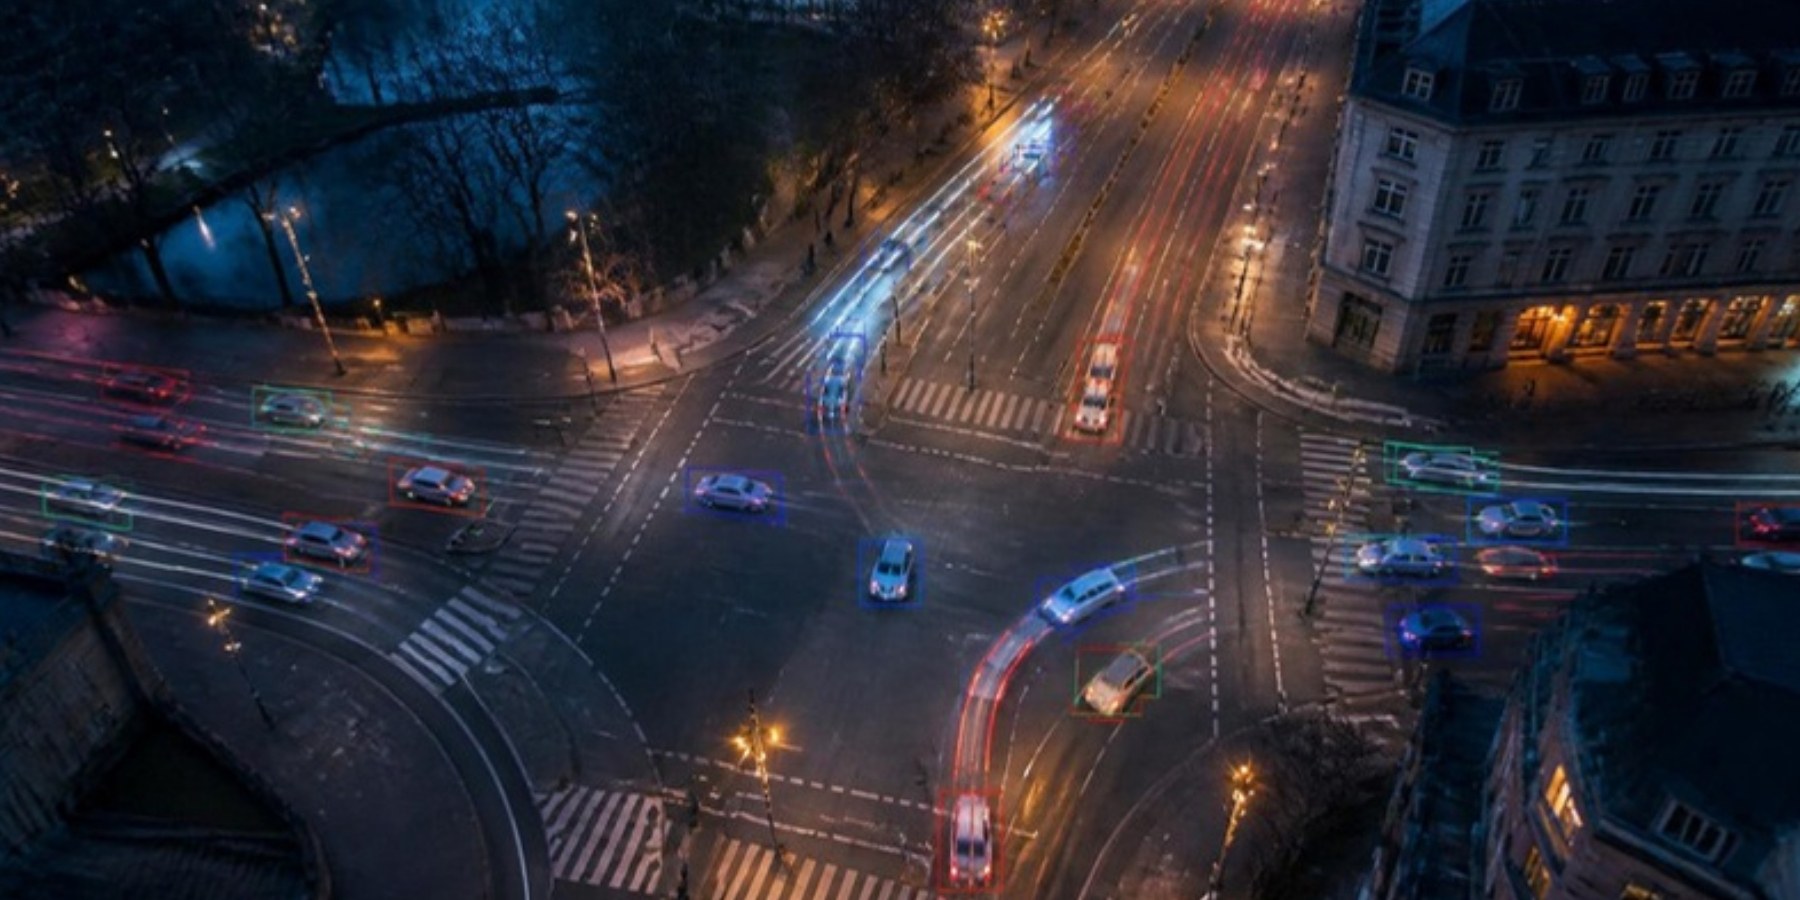
Unsere Feldtests mit KI-Kameras haben das greifbar gemacht. Bei wenig Verkehr kam ein leichtgewichtiger Detektor mit einfacher Filterung nah an die manuelle Referenz heran. In Stoßzeiten, wenn Gruppen gleichzeitig vorbeikamen, hatte jedes Modell Probleme: Personen wurden zusammengefasst oder übersehen. Die Montage war so wichtig wie das Modell. Am besten waren die Zählungen dort, wo sich Wege nicht kreuzten und niemand am Rand des Sichtfelds stehen blieb; auch die Montagehöhe veränderte die Ergebnisse, vor allem bei Gedränge. Die Erkennungsschwelle anzupassen, erwies sich als Abwägung, nicht als Lösung: Eine niedrigere Schwelle fand mehr Objekte – und viel mehr falsche.
Wir haben gelernt: Ein Echtzeitsystem muss dort und so getestet werden, wo und wie es später laufen wird. Einige Regeln haben sich für uns bewährt:
- Erst die Aufnahme, dann der Vergleich. Wir nehmen echtes Material am Zielort auf und lassen jedes Kandidatenmodell auf derselben Aufnahme laufen. Wer Modelle an verschiedenen Tagen oder in verschiedenen Szenen vergleicht, vergleicht das Wetter, nicht die Modelle. Auf Edge-Kameras haben wir dafür Aufnahme und Wiedergabe ins Gerät eingebaut, weil die Erkennung normalerweise auf dem Live-Stream läuft.
- Manuelle Zählung als Referenz. Bei Zählaufgaben ist unsere Referenz eine manuelle Zählung derselben Aufnahme. Das ist mühsam – und der einzige Weg, den tatsächlichen Fehler zu kennen.
- Ein gemeinsames Maß. Für die Erkennungsqualität ist das Standardmaß die Mean Average Precision (mAP), wie sie für den öffentlichen COCO-Datensatz definiert ist. Eine Erkennung gilt als richtig, wenn der vorhergesagte Rahmen das echte Objekt ausreichend überdeckt, gemessen als Intersection over Union (IoU). COCO-mAP mittelt die Präzision über zehn IoU-Schwellen von 0,50 bis 0,95 in Schritten von 0,05 und belohnt damit Modelle, die Objekte präzise lokalisieren, nicht nur ungefähr.
- Was der Anwendungsfall braucht. mAP zeigt, wie gut ein Modell Objekte in Einzelbildern findet. Eine Zählanwendung braucht außerdem die richtige Zahl über die Zeit, in jede Richtung, in ruhigen und belebten Phasen. Beide Werte zählen, und sie stimmen nicht immer überein.
- Ruhige und belebte Stunden. Auf einem leeren Gehweg sieht jedes Modell gut aus. Wir testen bei ruhigem wie bei dichtem Verkehr, und auch Nacht und schlechtes Wetter gehören in einen Testplan.
- Tests auch nach dem ersten Erfolg. Echtzeitsysteme verändern sich: Firmware-Updates, neue Modelle, eine umgehängte Kamera. Wir testen manuell und automatisiert, mit einem Testbericht in jeder Phase – so zeigt sich, ob eine Änderung, die an einer Stelle hilft, an anderer Stelle etwas kaputt macht.
Benchmarks eignen sich gut für eine Vorauswahl. Die Entscheidung fällt im Feldtest.
Von der Machbarkeitsstudie zum Rollout
Projekte zur Bildverarbeitung in Echtzeit scheitern selten am Modell. Nach unserer Erfahrung scheitern sie früher: am Zugang zu Daten, an Kosten, die niemand eingeplant hat, oder an der Frage, wer das System betreiben wird. Deshalb arbeiten wir in drei Schritten.
1. Machbarkeitsstudie. Bevor die Entwicklung beginnt, prüfen wir, ob das Problem überhaupt KI braucht, welche Daten verfügbar sind, was Aufbau und Betrieb des Systems kosten und ob die Verarbeitung am Edge oder in der Cloud stattfinden soll. Datenschutz (DSGVO) und der EU AI Act sind von Anfang an Teil des Designs, kein Audit am Ende. Was eine solche Studie umfasst, beschreiben wir in Bevor Sie KI bauen: Machbarkeit, Daten, Ethik und Recht.
2. Proof of Concept mit echten Daten. Ein Proof of Concept läuft mit Daten vom Zielort, unter den Bedingungen, denen das System später begegnet. In unserer KI-Machbarkeitsstudie zur Verkehrsanalyse erwiesen sich der Zugang zu Daten und das Betriebsmodell als größte Hürden, nicht die Genauigkeit des Modells. Viele Städte bieten keinen direkten Zugriff auf ihre Kamerastreams, und manche Organisationen dürfen solche Systeme nur mit eigenem Personal betreiben. Beides lässt sich früh günstig klären – spät herausgefunden, wird es teuer.
3. Rollout auf dem Gerät, mit Feldtests. Das fertige System läuft dort, wo die Bilder entstehen. Für uns heißt das: Hardware mit Blick auf die Modelle auswählen, Aufnahme und Wiedergabe ins Gerät einbauen, damit es sich testen lässt, und Feldtests an der echten Montageposition gegen Referenzdaten durchführen.
Echtzeitanforderungen betreffen jede Schicht. Deshalb decken wir die ganze Kette mit einem Team ab: Firmware und Elektronik, Kommunikationsprotokolle wie UWB, LoRaWAN, RFID und ZigBee und darüber die KI-Modelle. Beide Seiten beschreiben wir ausführlicher unter Internet der Dinge (IoT) und KI-Entwicklung.
Das Wichtigste in Kürze
- Ein Zeitbudget pro Bild. Bei 30 Bildern pro Sekunde teilen sich alle Schritte von der Aufnahme bis zur Entscheidung 33 Millisekunden. Ob ein System mithält, entscheiden die verspäteten Bilder, nicht der Durchschnitt.
- Ergebnisse statt Pixel. Rohes Full-HD-Video kommt auf etwa 187 Megabyte pro Sekunde. Berechnet das Gerät die Antwort selbst und sendet nur ein paar Zahlen, ist das schneller, entlastet das Netz und hält die Bilder auf dem Gerät.
- Sensoren, die unterschiedlich versagen. Kameras liefern unscharfe Bilder, Bewegungssensoren driften, Funkortung leidet unter Reflexionen. Kombiniert – etwa mit einem Kalman-Filter – gleicht eine Quelle die Schwächen der anderen aus.
- Das Feld vor dem Benchmark. Gedränge und Montageposition haben unsere Ergebnisse ebenso stark verändert wie die Wahl des Modells. Deshalb testen wir mit Aufnahmen vom Zielort.
Wenn Sie an einem Gerät arbeiten, das in Echtzeit sehen, messen und reagieren soll, sprechen wir gern mit Ihnen darüber – schreiben Sie uns.
Angebot oder Beratung anfragen

Wir sehen uns Ihr Projektkonzept und seinen aktuellen Stand gemeinsam an.

Sie erhalten von uns einen ersten Vorschlag zum Projektumfang sowie eine Zeit- und Kostenschätzung.

Die Beratung ist durch eine Geheimhaltungsvereinbarung (NDA) geschützt.